

电商数据抓取项目里,最容易被低估的不是请求发送、页面解析或接口调试,而是“抓下来以后能不能统一使用”。我曾经处理过一批多平台商品数据:三个来源都提供了“商品 ID”和“价格”,但合并后出现了重复商品、价格倒挂和库存异常。回头检查才发现,问题并不在抓取程序,而在字段标准没有定义清楚:一个 ID 是商品页面编号,一个是 SPU 编号,另一个其实是 SKU 编号;所谓“价格”则分别代表起售价、当前售价和券后价。
字段名相同,不等于业务含义相同;字段名不同,也不等于不能统一。
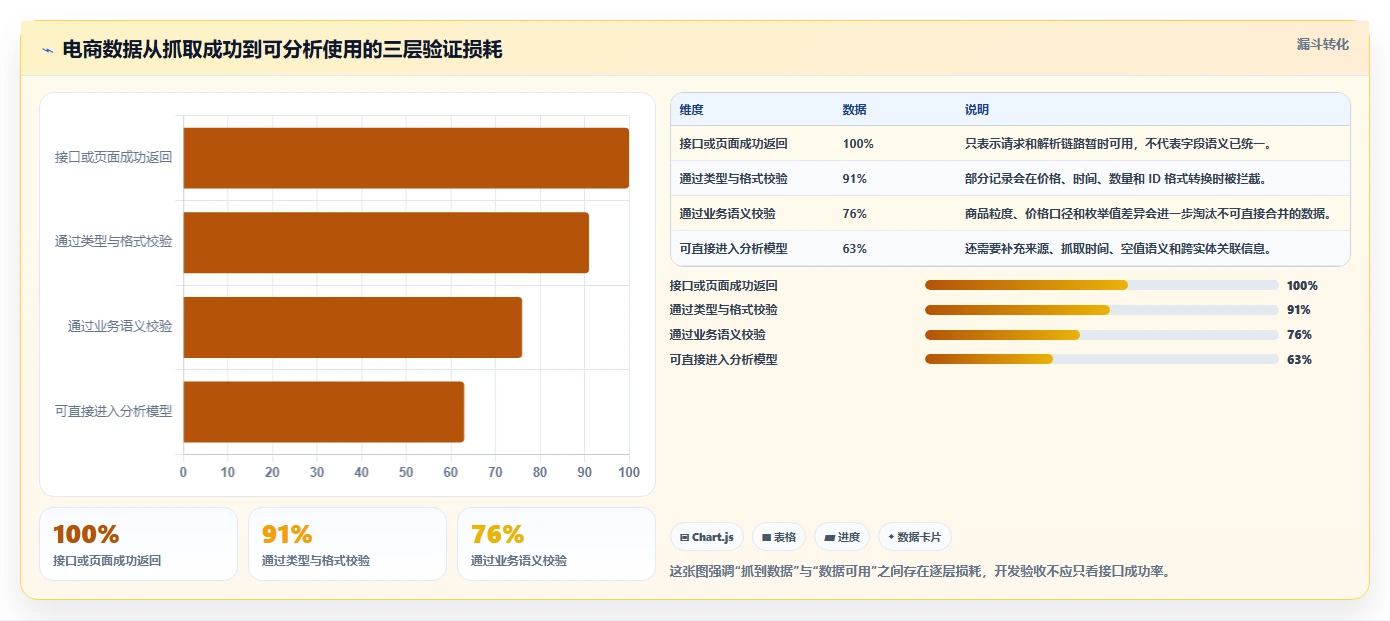
开发人员通常会用几个结果判断采集任务是否成功:接口返回 200、页面解析出商品标题、数据库成功写入记录。这些判断只能说明数据链路暂时可用,不能说明数据具备跨平台分析能力。
真正需要验证的是:同一个标准字段,在不同来源中是否表示同一类实体、同一种口径、同一个单位,并且能接受同一套校验规则。如果这些条件不成立,数据库里越早写入“统一字段”,后期返工成本越高。
| 表面现象 | 开发人员可能的处理 | 实际风险 |
|---|---|---|
| 字段名称不同 | 直接建立别名映射 | 名称统一了,粒度可能仍然不同 |
| 字段类型不同 | 全部转成字符串 | 失去金额、数量、时间的计算能力 |
| 价格格式不同 | 删除货币符号后入库 | 起售价、活动价、券后价被混为一谈 |
| 字段为空 | 统一写成空字符串或 0 | 未知、不适用、抓取失败无法区分 |
| 来源平台改版 | 临时修复解析器 | 历史数据与新数据可能产生口径断裂 |
因此,我在设计电商数据模型时,会把统一字段看成一份“数据契约”。这份契约至少要规定字段名称、业务定义、实体粒度、数据类型、单位、取值范围、空值语义、来源映射和版本变更方式。
第一层是语法层验证,检查字段能否被程序正确解析,例如价格是否可以转换为整数分,时间是否可以转换为带时区的时间类型。
第二层是语义层验证,检查字段是否真的表达了预期业务含义。例如 `product_id` 到底代表商品页面、SPU 还是 SKU,`selling_price` 到底是页面展示价还是最终成交价。
第三层是使用层验证,检查字段能否支持后续任务,例如跨平台商品关联、价格趋势分析、库存预警、报表汇总和异常追踪。如果一个字段在数据库里看起来很规范,却无法支持这些任务,它就还没有成为合格的统一字段。
有些团队为了降低开发复杂度,只保留商品 ID、标题、价格、库存四五个字段,认为字段越少越容易统一。实际情况往往相反:缺少价格类型、币种、抓取时间和来源 ID 后,主表看似简单,业务解释却全部转移到人工沟通和临时 SQL 中。
我更关注的是字段是否“足够表达业务,又没有把不同概念硬塞进同一列”。例如,与其设计一个含义模糊的 `price`,不如拆出 `list_price`、`selling_price`、`coupon_price`、`currency` 和 `captured_at`。字段增加了,但数据解释成本下降了。
电商抓取中最常见的重复问题,来自实体粒度混乱。一个商品详情页可能对应一个 SPU,但页面下有多个颜色、尺寸和容量组合,每个组合又可能对应一个 SKU。平台接口中的“商品编号”有时指页面编号,有时指 SPU,有时指店铺内部编号。
如果开发人员把这些编号全部映射到 `product_id`,后续就会出现三种典型错误:一是同一个 SPU 被重复统计;二是 SKU 价格被误当成商品统一价格;三是库存被按商品页面汇总后产生虚高或虚低。
| 实体层级 | 典型含义 | 适合承载的字段 | 不应直接替代 |
|---|---|---|---|
| 商品页面 | 用户访问和展示的页面对象 | 页面 URL、页面标题、来源页面 ID | SKU 库存、统一规格价格 |
| SPU | 一组具有共同商品属性的抽象集合 | 品牌、类目、通用标题、商品属性 | 具体颜色库存、单个规格成交价 |
| SKU | 可售卖的具体规格组合 | 规格值、SKU 价格、SKU 库存、条码 | 整个商品集合的统一标题 |
| 店铺商品编号 | 某个平台或店铺内部使用的编号 | 来源系统 ID、来源平台 | 跨平台全局商品 ID |
这里有一个容易被忽略的判断:统一字段不一定要消灭来源差异,而是要把来源差异显式保存下来。我通常会同时保留 `source_platform`、`source_product_id`、`source_spu_id` 和 `source_sku_id`,再根据业务需要建立内部关联 ID。这样即使后面发现映射错误,也能追溯到原始记录。
很多数据表把价格设计成 `price decimal(10,2)`,然后在采集程序里把页面上最显眼的数字写进去。这种做法在单平台、单页面分析中可能勉强可用,但一旦进入跨平台比较,就会暴露问题。
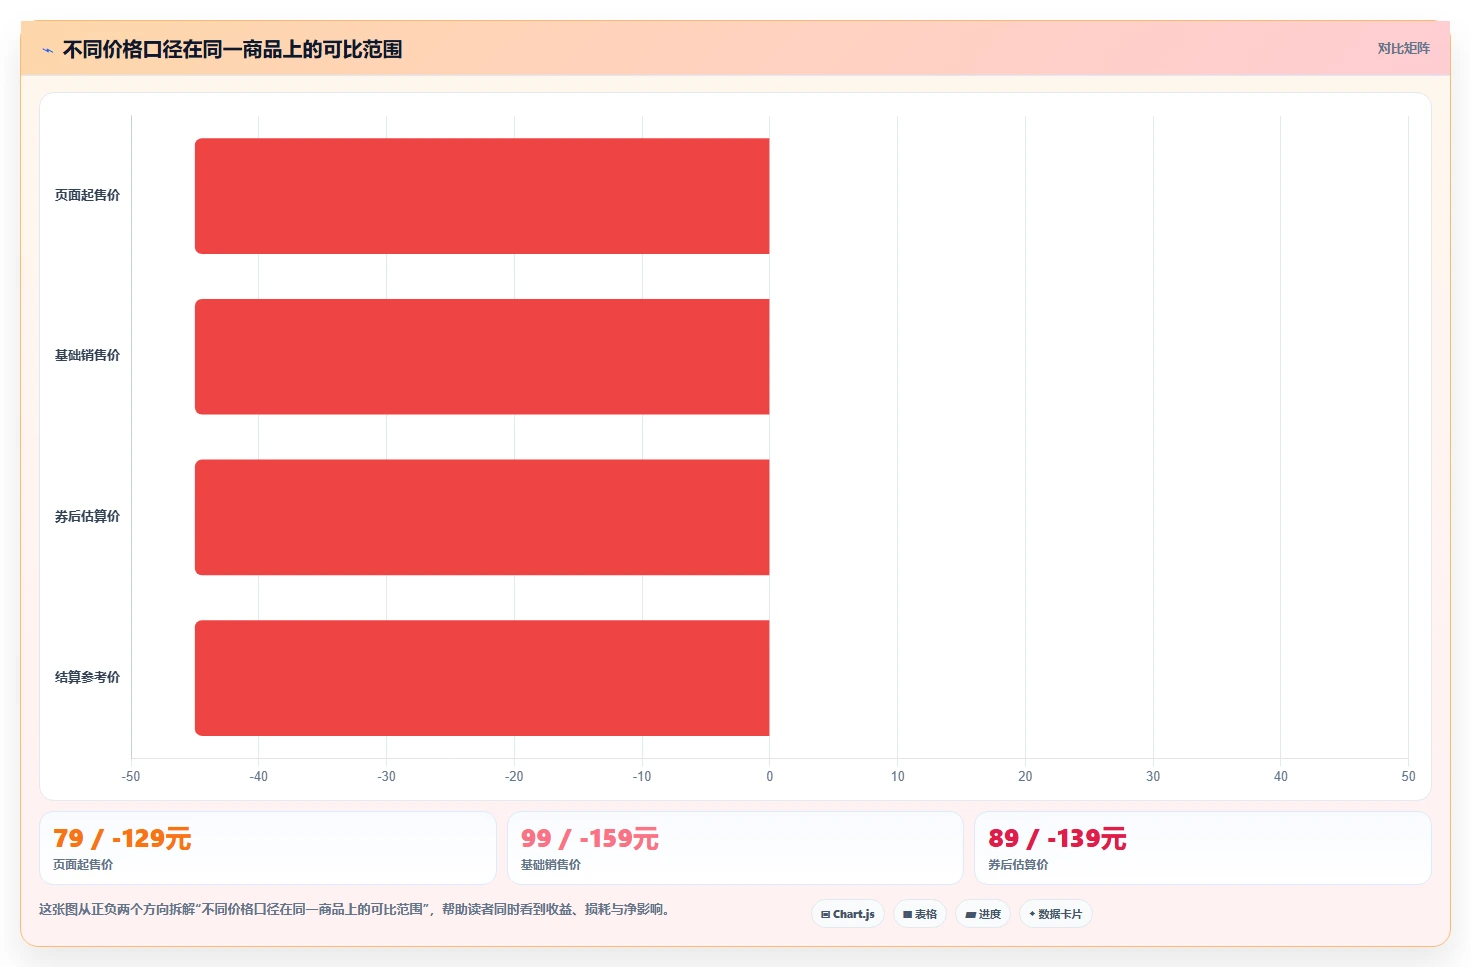
“¥99 起”可能是最低规格价格;“券后 ¥89”需要满足领券条件;会员价可能只对特定用户可见;活动价还可能有开始和结束时间。如果这些价格都被写入同一个字段,统计结果看起来精确,实际上比较口径并不一致。
| 字段 | 建议定义 | 常见风险 |
|---|---|---|
list_price | 页面或平台标示的参考价、划线价 | 可能是展示口径,不代表实际成交价 |
selling_price | 当前页面展示的基础可售价格 | 可能是起售价或某一默认 SKU 价格 |
coupon_price | 在满足优惠条件后的估算价格 | 需要记录优惠券条件和计算时间 |
sku_price | 具体 SKU 对应的价格 | 不能直接替代 SPU 层面的价格 |
price_captured_at | 该价格被观察到的时间 | 缺少时间就无法解释动态变价 |
我的经验是,价格字段要先回答“这个价格用于什么决策”。如果用于商品列表监控,可以保存页面展示价;如果用于竞品比价,需要拆分价格类型和 SKU 规格;如果用于财务核算,则还要引入订单、优惠分摊和结算口径,不能只依赖公开页面价格。
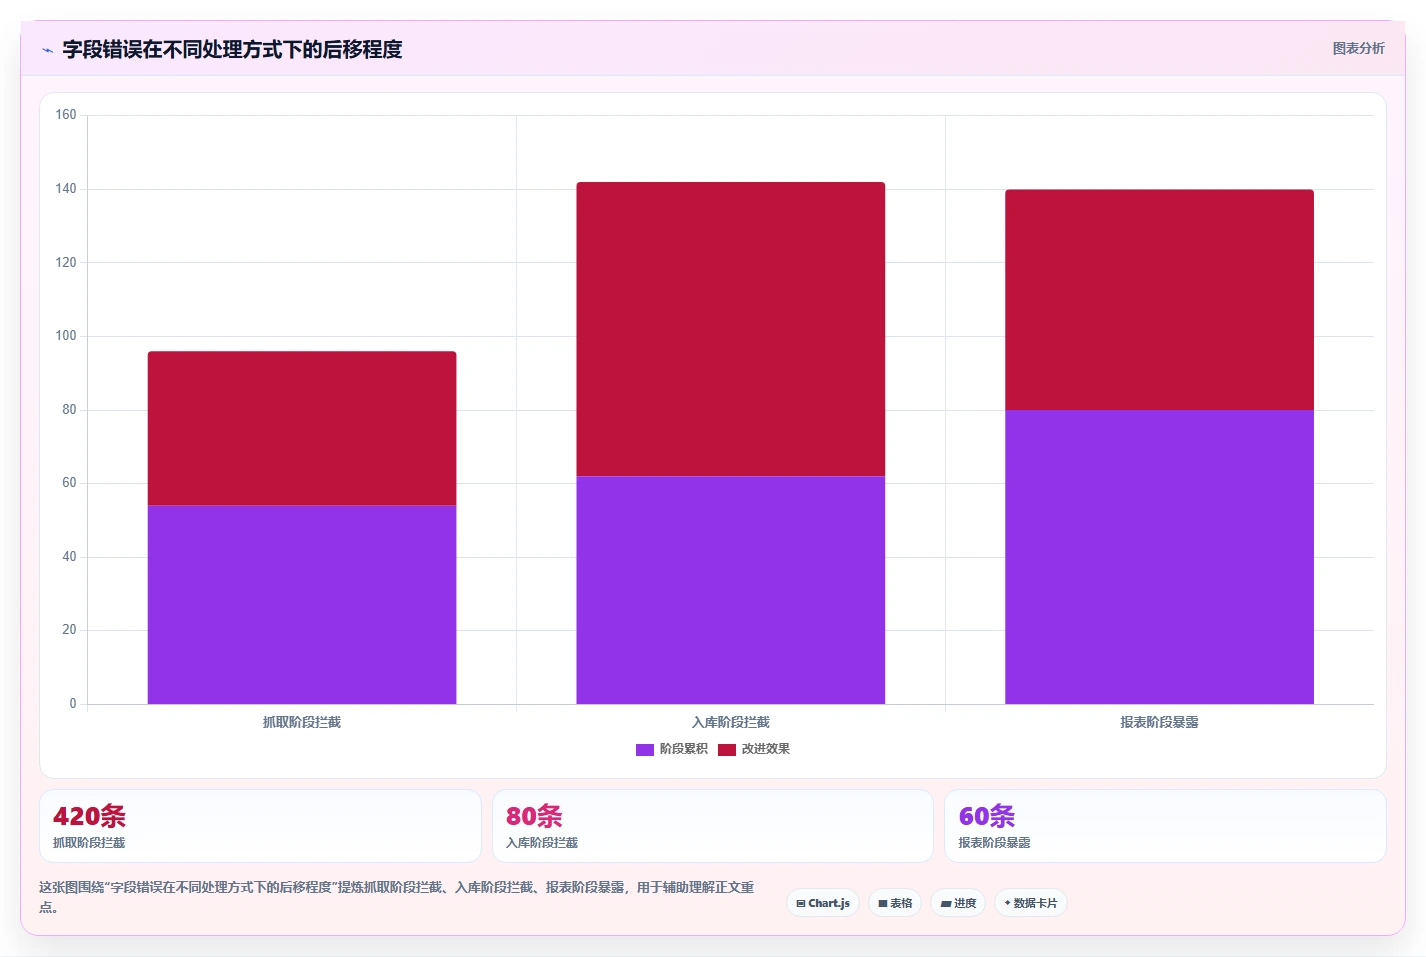
库存字段的空值处理也很容易造成业务误判。页面没有展示库存数量,可能意味着平台不公开具体数量,也可能是接口权限不足、页面异步加载失败,或者该商品采用“有货/无货”而不是数值库存。
如果程序把所有空值转成 0,分析人员会认为这些商品缺货;如果把所有空值转成无限库存,又会误导补货判断。更稳妥的做法是拆开库存数值和库存可见性。
| 字段 | 示例值 | 解释 |
|---|---|---|
inventory_quantity | 0、25、NULL | 可识别的库存数量;NULL 不等于 0 |
inventory_status | in_stock、out_of_stock、unknown | 商品可售状态或库存状态 |
inventory_visibility | numeric、boolean、hidden | 来源平台是否公开数值库存 |
inventory_observed_at | 带时区时间 | 库存观察时间,避免与入库时间混淆 |
在数据仓库中,最危险的操作之一是看到两个来源都有 `product_id`,就直接把它们拼接到同一列。开发人员可能觉得字段名一致代表标准已经建立,但实际上这只是命名层面的相似。
我会先要求业务方和采集方回答三个问题:这个 ID 的生成主体是谁?它的唯一范围是什么?它对应哪个实体层级?如果答案分别是“平台系统”“店铺范围内唯一”“商品页面”,那它就不应该被直接当成跨平台全局商品 ID。
更稳妥的模型是把来源 ID 和内部 ID 分开:
source_platform = "platform_a"
source_product_id = "A-00981"
source_spu_id = "A-SPU-1207"
source_sku_id = "A-SKU-1207-BLACK-M"
canonical_product_id = "CP-0001842"
其中 `canonical_product_id` 只有在经过匹配规则或人工确认后才能生成。没有足够证据时,宁可保留多个来源记录,也不要强行合并成一个“看起来统一”的商品。
把数字转成字符串,短期内确实可以避免转换报错,尤其是在处理带货币符号、逗号或非标准文本时。但它会把数据质量问题推迟到报表和分析阶段。
例如,字符串形式的价格无法可靠排序,“100”可能排在“99”前面或后面取决于处理方式;库存无法直接求和;时间字符串也可能因为格式不同而无法按时间比较。字符串适合保留原始值,不适合替代标准值。
| 字段类型 | 原始字段建议 | 标准字段建议 | 设计理由 |
|---|---|---|---|
| 金额 | price_raw string | selling_price_cent int64 | 保留原文,同时用整数分参与计算 |
| 数量 | stock_raw string | inventory_quantity *int64 | 区分 0、未知和无法解析 |
| 时间 | time_raw string | time.Time | 支持时区、排序和时间窗口分析 |
| 状态 | status_raw string | ProductStatus | 通过枚举限制非法值进入主表 |
Go、Java 等语言都有默认零值或空值机制,这对程序初始化很方便,却容易掩盖业务语义。例如 `int64` 的默认值是 0,但库存为 0 和库存没有被平台公开,是两种完全不同的事实。
在字段设计阶段,我会把“0”“空”“未知”“不适用”“抓取失败”分别定义。对分析系统来说,这种区分甚至比字段本身是否必填更重要,因为错误的零值会进入聚合结果,并且很难被察觉。
结构体可以很好地表达字段名称、类型、嵌套关系和序列化标签,但它无法独立表达完整业务标准。比如 `SellingPrice int64` 只能说明这是一个整数,不能说明单位是分还是元,也不能说明是否包含优惠券。
因此,结构体应该被看作标准的“程序接口层”,而不是标准的全部。字段字典、映射规则、校验逻辑、样本数据、版本记录和异常处理机制仍然需要单独维护。
首次抓取到的样本通常比较“干净”:标题完整、价格可见、库存字段存在、状态值也比较规范。但真实运行后会遇到缺货商品、预售商品、组合商品、价格区间、无品牌商品、跨境币种和页面改版。
我建议至少准备五类回放样本:正常商品、规格多商品、无库存商品、促销商品和异常页面。字段标准只有经过这些样本的反复回放,才算真正具备上线条件。
字段标准设计不应从字段名开始,而应从实体关系开始。我通常会先画出商品页面、SPU、SKU、店铺、类目、价格记录和库存记录之间的关系,再确定每张表的主键与粒度。
例如,商品主表可以按 SPU 粒度组织,SKU 表按具体规格组织,价格历史表则按 SKU、价格类型和观察时间组织。这样做的好处是,价格变化不会覆盖旧值,库存变化也不会被错误地更新到商品主表。
| 数据表 | 建议粒度 | 主键示例 | 关键关联字段 |
|---|---|---|---|
| 商品主表 | 一个标准商品或 SPU 一行 | canonical_product_id | 品牌、类目、标题 |
| SKU 表 | 一个具体规格一行 | canonical_sku_id | 商品 ID、规格属性 |
| 价格历史表 | 一个 SKU 在一个时间点的一种价格一行 | SKU、价格类型、观察时间 | 金额、币种、条件 |
| 库存观察表 | 一个 SKU 在一个时间点的一次观察一行 | SKU、观察时间、来源 | 库存数、库存状态 |
| 来源映射表 | 一个平台实体与标准实体的一条关联一行 | 平台、来源 ID | 标准 ID、匹配置信度 |
字段定义不能只写“商品售价”“商品状态”这种模糊描述。好的定义应该包含对象、条件和时间。例如:`selling_price_cent` 表示在指定抓取时间、指定来源平台、指定 SKU 和默认展示条件下观察到的基础销售价,单位为最小货币单位。
有了这样的定义,测试才能落地。我们可以检查金额是否为非负数、币种是否存在、价格类型是否在枚举范围内、价格观察时间是否与抓取批次一致,也可以检查价格是否与具体 SKU 关联。
| 字段 | 不合格定义 | 可测试定义 |
|---|---|---|
| 商品标题 | 商品名称 | 来源页面主标题,去除页面级促销标签后的文本 |
| 销售价 | 商品当前价格 | 指定 SKU 在指定观察时间的基础可售价格,单位为分 |
| 库存 | 商品剩余库存 | 来源公开且可解析的库存数量;未公开时保留 NULL 并标记可见性 |
| 状态 | 商品状态 | 标准枚举中的可售、售罄、预售、下架或未知状态 |
在实际项目中,我会要求字段字典至少包含以下内容:标准字段名、中文名称、业务定义、数据类型、单位、是否必填、允许空值、来源字段、转换逻辑、校验规则、示例值、负责人和版本号。
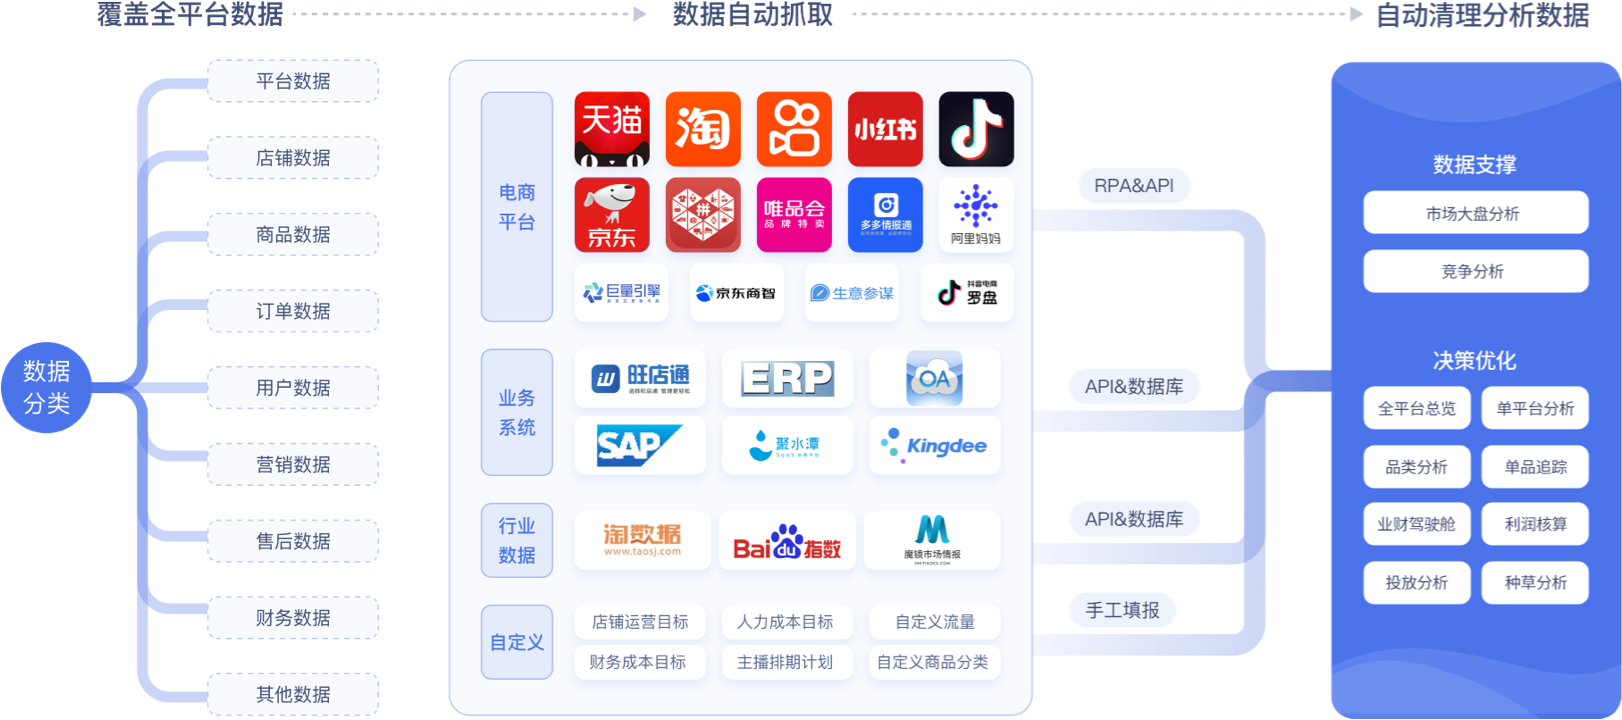
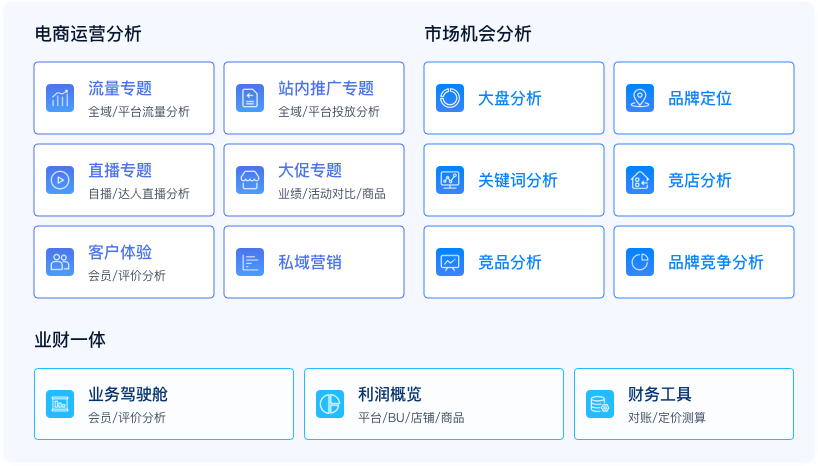
如果数据会进入分析平台,还需要补充刷新频率、数据延迟、历史保留周期和权限范围。九数云这类分析工具在连接多来源数据时,真正依赖的并不是“字段名称看起来一致”,而是维度、指标、时间和关联关系能否稳定维护。前端图表只能展示结果,不能替代前置的数据口径治理。
| 字段名 | 类型 | 必填 | 单位 | 来源 | 核心校验 |
|---|---|---|---|---|---|
canonical_product_id | string | 是 | 无 | 内部匹配服务 | 非空、稳定、不可重复 |
source_product_id | string | 是 | 无 | 来源平台 | 保留前导零,按平台范围唯一 |
selling_price_cent | int64 | 否 | 分 | 商品页面或接口 | 大于等于 0,币种不能为空 |
inventory_quantity | int64 nullable | 否 | 件 | 库存接口或页面 | 不能小于 0,空值需记录原因 |
captured_at | timestamp | 是 | 时区明确 | 采集任务 | 不可晚于任务执行时间过多 |
我不建议直接把解析结果写入最终分析表。比较稳定的分层方式是:原始层保存原文和请求上下文,标准层完成字段映射、类型转换和业务校验,应用层根据具体场景生成商品监控、竞品分析或库存分析数据集。
原始层的价值在于可追溯。平台改版后,如果只保留转换后的标准值,开发人员很难判断是原始页面变化、解析规则变化,还是标准映射逻辑变化。保留必要的原始字段和抓取批次,可以支持历史回放。
标准层的价值在于可复用。不同业务报表不需要重复解析平台字段,而是统一使用已经通过校验的标准模型。应用层则可以根据业务需要选择价格口径,不必强迫所有分析都依赖同一个模糊字段。
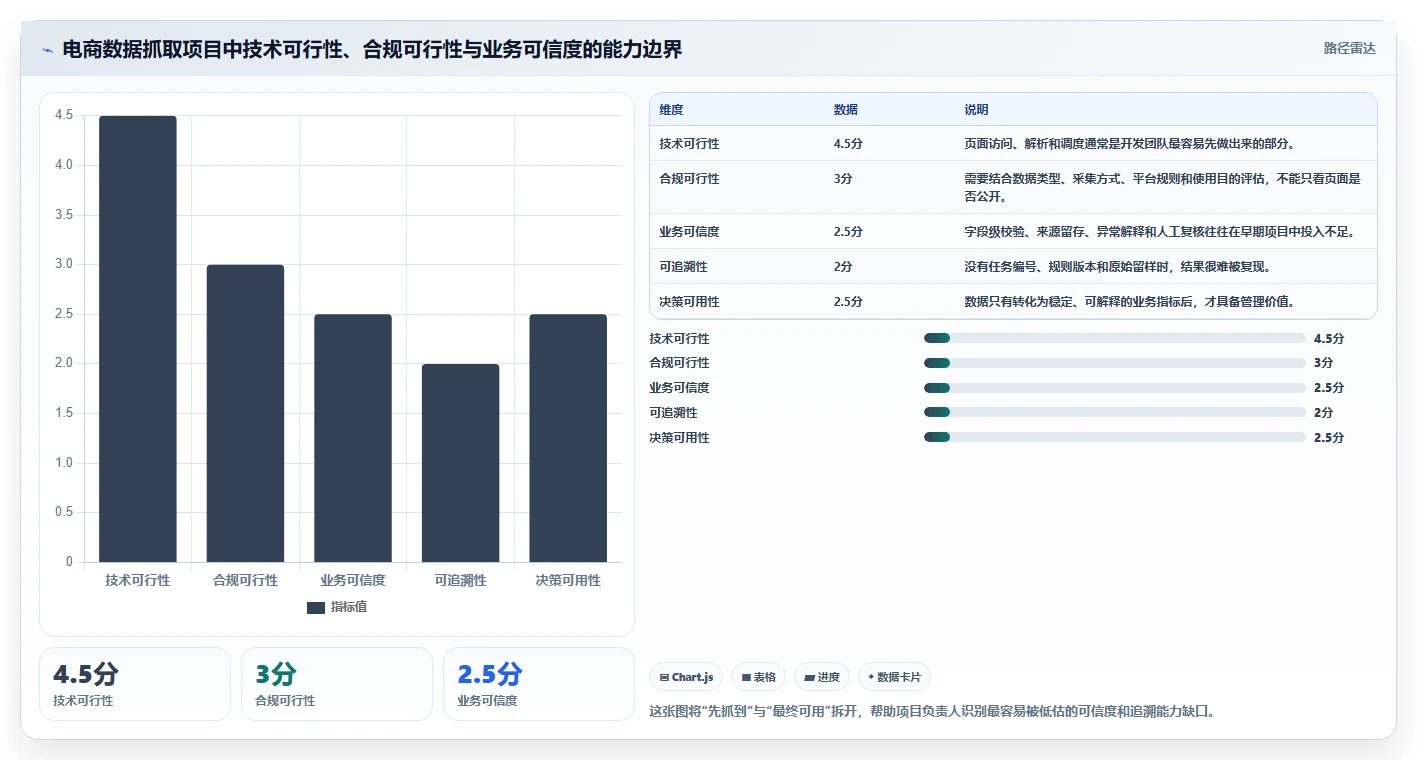
下面的示例以商品和 SKU 为对象。金额使用最小货币单位存储,库存使用指针类型区分“库存为零”和“没有可识别库存”,同时保留来源平台与抓取时间。
package ecommerce
import "time"

type ProductStatus string

const (

StatusOnSale   ProductStatus = "on_sale"

StatusSoldOut  ProductStatus = "sold_out"

StatusPresale  ProductStatus = "presale"

StatusOffShelf ProductStatus = "off_shelf"

StatusUnknown  ProductStatus = "unknown"

)

type Product struct {

CanonicalProductID string        json:"canonical_product_id"

SourcePlatform     string        json:"source_platform"

SourceProductID    string        json:"source_product_id"

SPUID              string        json:"spu_id,omitempty"

Title              string        json:"title"

Brand              string        json:"brand,omitempty"

CategoryID         string        json:"category_id,omitempty"

Status             ProductStatus json:"status"

Currency           string        json:"currency"

CapturedAt         time.Time     json:"captured_at"

SchemaVersion      string        json:"schema_version"

SKUs               []SKU         json:"skus,omitempty"

}

type SKU struct {

CanonicalSKUID  string         json:"canonical_sku_id"

SourceSKUID     string         json:"source_sku_id"

SpecValues      map[string]string json:"spec_values,omitempty"

SellingPriceCent *int64         json:"selling_price_cent,omitempty"

InventoryQty    *int64         json:"inventory_quantity,omitempty"

InventoryStatus string         json:"inventory_status"

}
这里的结构体有几个刻意的设计。第一,标准 ID 和来源 ID 不混用;第二,商品状态使用受限枚举,而不是任意字符串;第三,价格和库存允许为空,但不通过默认 0 掩盖缺失;第四,保留 `schema_version`,为后续字段变更提供兼容依据。
浮点数适合展示,不适合直接承担精确金额计算。以 19.90 元为例,如果在多个语言和序列化环节中使用浮点类型,可能出现精度误差。使用 `1990` 表示 1990 分,可以降低计算和比较的不确定性。
但整数分本身仍然不够。必须在字段字典中明确币种和单位,否则另一个系统可能把 `1990` 解释为 1990 元。对于多币种业务,还要保存币种代码,必要时保存汇率来源和换算时间。
func yuanToCent(yuan int64, fen int64) int64 {
return yuan*100 + fen

}

type Money struct {

AmountMinor int64  json:"amount_minor"

Currency    string json:"currency"

}

type PriceObservation struct {

ProductID  string    json:"product_id"

SKUID      string    json:"sku_id"

PriceType  string    json:"price_type"

Amount     Money     json:"amount"

CapturedAt time.Time json:"captured_at"

}基础规则关注数据能不能被系统正确处理,例如 ID 非空、金额不小于零、币种属于允许集合、时间可解析。业务规则关注字段之间是否自洽,例如售罄商品不应同时出现正库存,销售价是否高于原价,SKU 是否能关联到有效 SPU。
func ValidateProduct(p Product) []string {
var errors []string

if p.CanonicalProductID == "" {

errors = append(errors, "canonical_product_id is required")

}

if p.SourcePlatform == "" || p.SourceProductID == "" {

errors = append(errors, "source identity is incomplete")

}

switch p.Status {

case StatusOnSale, StatusSoldOut, StatusPresale,

StatusOffShelf, StatusUnknown:

default:

errors = append(errors, "invalid product status")

}

if p.Currency == "" {

errors = append(errors, "currency is required")

}

for _, sku := range p.SKUs {

if sku.SellingPriceCent != nil && *sku.SellingPriceCent errors = append(errors, "selling price cannot be negative")

}

if sku.InventoryQty != nil && *sku.InventoryQty errors = append(errors, "inventory cannot be negative")

}

if sku.InventoryStatus == "out_of_stock" &&

sku.InventoryQty != nil && *sku.InventoryQty > 0 {

errors = append(errors, "inventory status conflicts with quantity")

}

}

return errors

}
实际生产环境中,可以将校验结果分成错误等级。阻断级错误直接拒绝入库;警告级错误允许入库但标记质量状态;信息级异常只进入日志。这样既不会因为一个非关键字段缺失导致整批数据报废,也不会让所有异常都静默通过。
不同平台的字段映射通常需要单独的适配器。平台 A 可能返回 `item_id`,平台 B 返回 `goodsNo`,平台 C 返回 `spu_code`。适配器的职责是读取来源结构,转换成标准结构,并在无法确认粒度时留下风险标记。
type SourceAItem struct {
ItemID    string json:"item_id"

Title     string json:"title"

SalePrice string json:"sale_price"

}

type MappingWarning struct {

Field   string json:"field"

Message string json:"message"

}

func MapSourceAItem(src SourceAItem) (Product, []MappingWarning) {

warnings := make([]MappingWarning, 0)

if src.ItemID == "" {

warnings = append(warnings, MappingWarning{

Field: "item_id",

Message: "source item id is empty",

})

}

return Product{

SourcePlatform:  "platform_a",

SourceProductID: src.ItemID,

Title:           src.Title,

Currency:        "CNY",

Status:          StatusUnknown,

SchemaVersion:   "v1",

}, warnings

}
这里没有把来源的 `item_id` 直接命名成标准 `canonical_product_id`,因为来源字段是否代表跨平台统一商品还没有被验证。宁可在字段名称上保留不确定性,也不要把不确定性伪装成确定性。
九数云这类数据分析工具适合把多个数据源连接起来,进行维度分析、指标计算和可视化展示。但如果不同平台的商品 ID、价格类型和时间口径没有统一,工具只能把不一致的数据更快地展示出来,不能自动判断“这个价格是不是同一种价格”。
在一个商品价格监控场景中,分析人员可能希望按品牌、类目和平台比较最低价。如果商品维度使用的是 SPU,价格事实却使用 SKU,图表中的最低价就可能只是某一规格的最低价格,而不是商品整体的可比价格。
因此,接入分析工具前,至少需要准备以下数据说明:商品和 SKU 的粒度、价格指标的定义、库存的空值规则、抓取时间的时区、平台来源字段和跨平台商品关联规则。
假设平台 A 展示某商品最低规格为 59 元,平台 B 默认 SKU 为 69 元,平台 C 显示券后价 55 元。若直接按商品 ID 和价格排序,平台 C 会被判断为最低价。但如果平台 C 的券需要满 200 元才能使用,平台 A 的 59 元是同规格基础售价,那么这个排序就没有决策价值。
解决办法不是在图表上添加更多颜色,而是把价格条件前置到数据模型中。至少要增加 `price_type`、`sku_id`、`promotion_condition` 和 `captured_at`,并在指标定义中明确哪些价格可以直接横向比较。
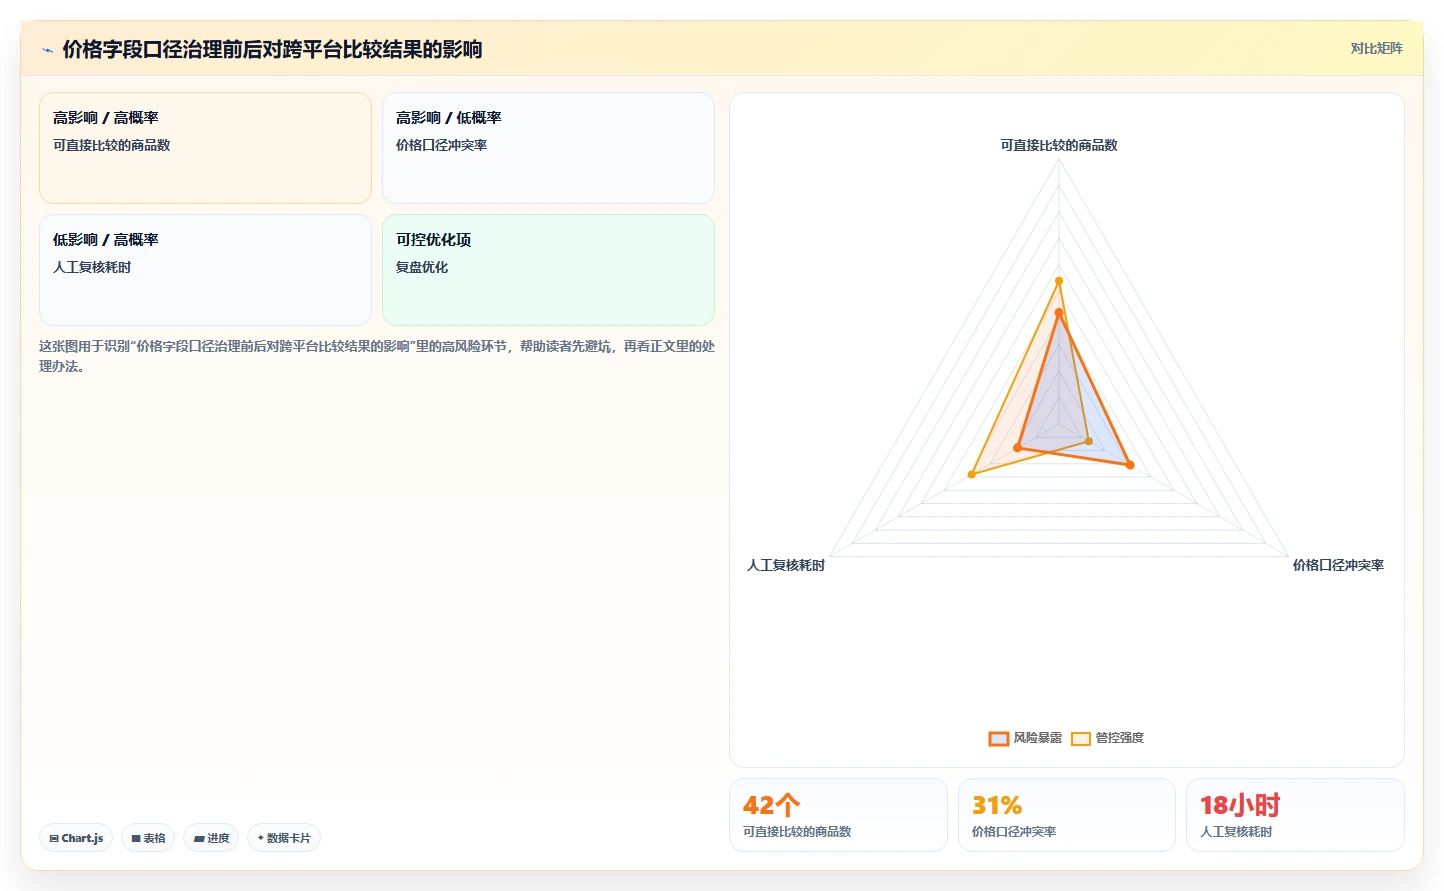
如果团队当前的核心问题是跨平台字段映射、数据质量校验和历史回放,优先投入应放在采集适配器、标准层和质量监控,而不是先购买更多看板功能。分析工具能帮助发现指标异常,但不能替你确认业务语义。
如果字段模型已经稳定,团队需要快速构建商品、价格、库存和渠道分析看板,那么接入九数云这类工具可以降低可视化和探索分析的开发成本。此时应将数据字典作为看板交付的一部分,而不是只交付图表链接。
假设同一款商品在三个平台分别出现 `A-1001`、`B-7782` 和 `C-19`。仅凭标题相似不能直接合并,因为标题可能包含不同规格、包装数量或促销描述。
我会采用分层匹配策略:先用品牌、类目和规格属性过滤,再用标准化标题、条码或平台公开关联信息辅助判断,最后将匹配结果分为确定、疑似和未匹配三类。疑似匹配需要保留置信度,不应直接进入精确的价格差指标。
| 匹配结果 | 进入主关联表 | 适合的业务用途 | 风险 |
|---|---|---|---|
| 确定匹配 | 可以 | 价格、库存和覆盖率分析 | 仍需保留来源 ID |
| 疑似匹配 | 谨慎进入 | 人工复核队列、候选商品池 | 可能把相似商品误合并 |
| 未匹配 | 不直接进入 | 新增商品发现、数据补全 | 不能参与跨平台价格比较 |
业务规则常写成“销售价不应高于原价”,但这并不是绝对规律。平台可能使用动态促销、会员专享、不同时间段价格或展示标签,导致页面上的参考价与当前价关系复杂。
因此,规则不应简单地把所有 `selling_price > list_price` 的记录拒绝入库。更好的做法是标记为警告,并检查价格类型、抓取时间和促销条件。如果业务确认该平台的参考价一定高于销售价,再将其升级为阻断规则。
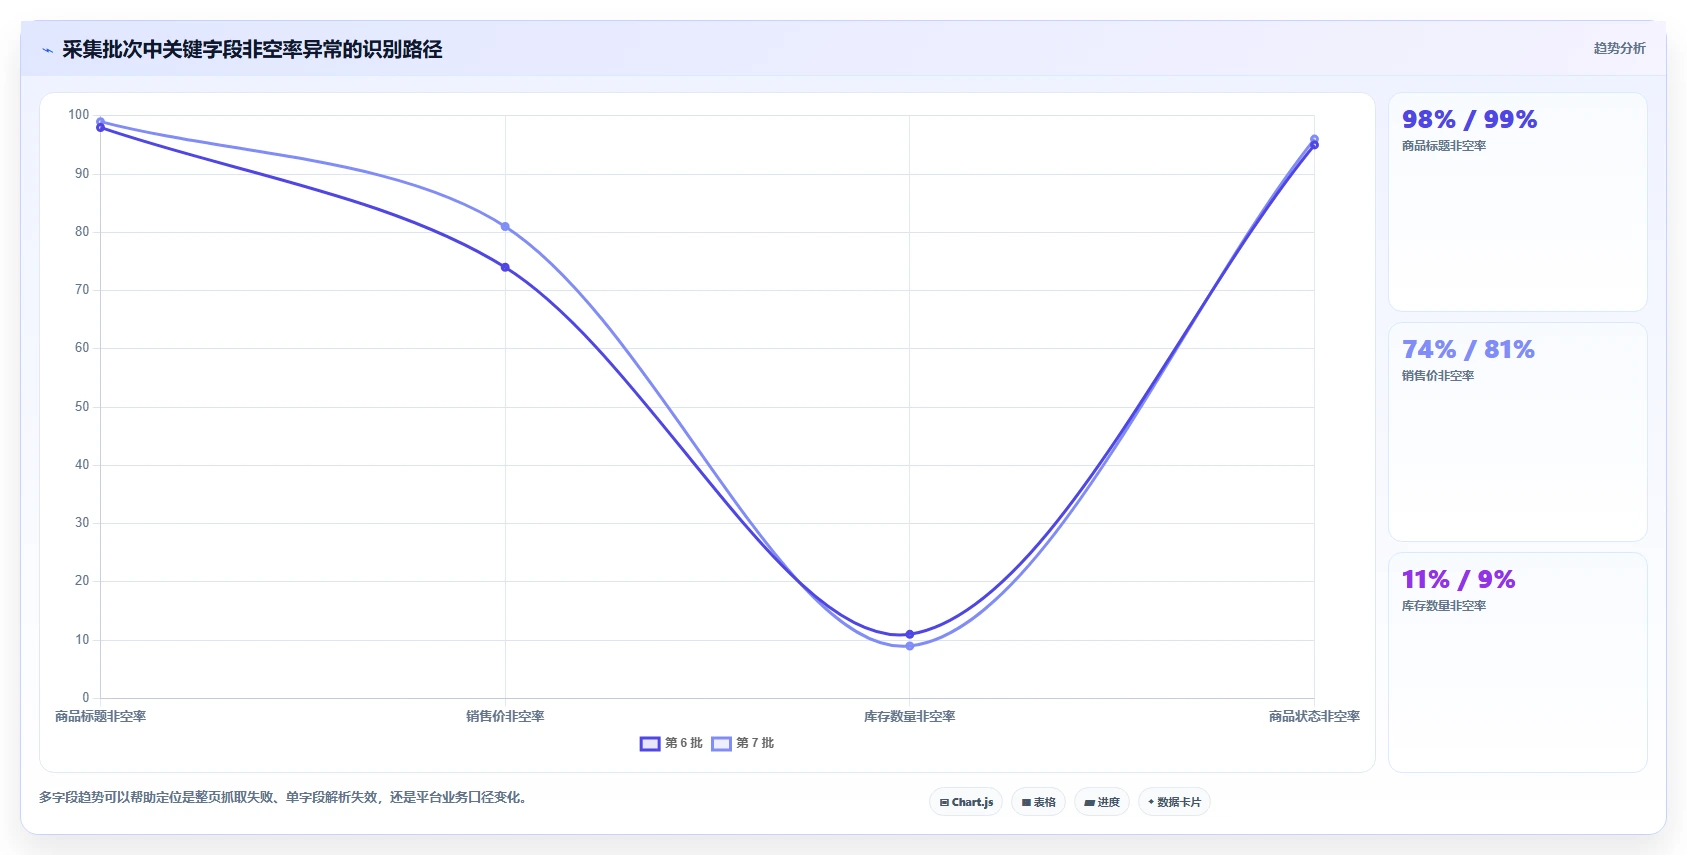
当某一批次的库存非空率从 82% 降到 9% 时,不应该立刻认为平台库存政策发生变化。更常见的原因是页面接口改版、异步接口没有等待完成、请求权限变化或解析器选择器失效。
我会把字段非空率做成按平台、字段和批次的监控指标,并设置基线偏差告警。这样,数据质量问题会在进入经营报表前暴露,而不是等业务人员发现库存图表突然全部为零。
SKU 与 SPU 的关联失败,可能是来源接口分开返回、字段截断、规格组合动态生成,或者平台使用了不同的编号体系。此时不应把 SKU 直接挂到一个临时商品 ID 下,因为后续商品聚合和库存分析会出现错误归属。
建议为关联状态增加 `linked`、`pending`、`orphan` 等枚举,并保留关联失败原因。对于孤立 SKU,可以进入待处理队列;对于确认无法关联的来源数据,可以单独保留,不要默默丢弃。
单平台项目不需要一开始就构建复杂的跨平台主数据体系,但仍然要保留来源 ID、SKU、价格类型和抓取时间。最低可行模型应该能回答:这个价格属于哪个规格、在什么时间观察到、是否包含优惠。
取舍是:模型可以暂时不做跨平台统一 ID,但不能省略实体粒度和时间字段。未来扩展到多个平台时,已有数据仍然可作为来源层使用。
此时最重要的不是尽快把所有商品合并,而是建立商品关联置信度和价格可比条件。不同平台如果没有共同条码或明确规格信息,自动匹配只能生成候选结果,不能把相似标题当作确定关联。
这里的主要取舍是准确率与覆盖率。放宽匹配规则可以提高覆盖率,却会增加错配风险;收紧规则可以提高可信度,却会减少可比较样本。我的建议是同时输出“确定匹配覆盖率”和“候选匹配覆盖率”,不要用一个数字掩盖这两种结果。
如果数据最终要被多个业务团队使用,字段字典和指标口径必须与看板一起交付。不能只说“销售额字段已经准备好”,而要说明销售额是否含税、是否扣除优惠、按订单时间还是支付时间统计。
取舍是开发速度与长期维护成本。直接把原始表接入看板,上线会更快,但每个报表都要重复解释字段;先建设标准层会增加前期工作,却能减少后续指标争议和重复清洗。
小团队不必复制大型数据治理平台的全部复杂度,但要坚持三个底线:保留原始字段、明确核心字段定义、设置最基本的自动校验。可以用代码仓库中的 YAML 或 CSV 文件维护字段字典,用单元测试验证映射结果。
取舍是暂时牺牲部分自动化能力,换取模型可理解、可维护。比起一开始建设复杂架构,先把字段定义写清楚,往往更适合资源有限的团队。
库存数据的决策风险高于普通展示数据。页面上显示“有货”并不等于仓库有可售库存,数值库存也可能存在延迟。因此,库存字段必须记录观察时间、可见性、来源和状态。
取舍是实时性与稳定性。更高频抓取可能获得更及时的页面变化,但会增加请求压力、解析失败和合规风险。对于公开页面监测,应根据平台规则和业务必要性设置合理频率,不要为了追求“实时”而无限增加采集频次。
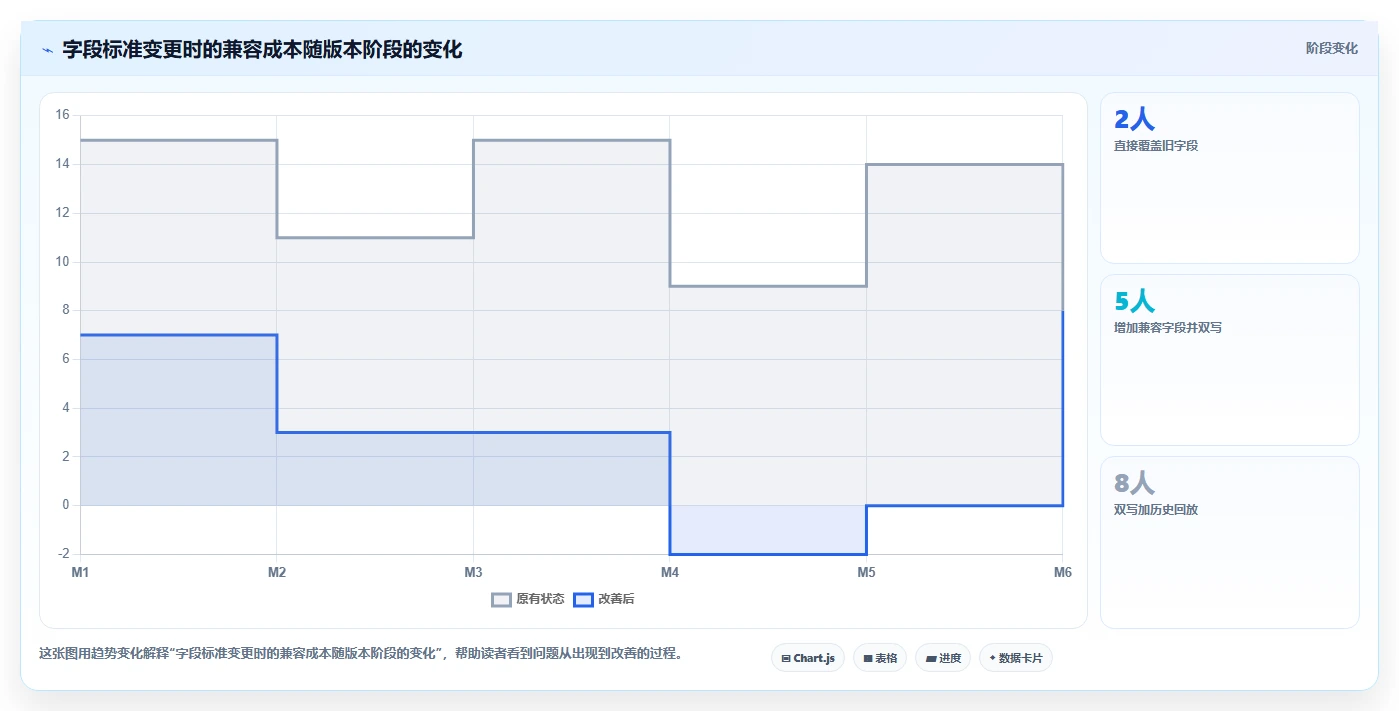
当业务新增 `coupon_price` 时,可以先作为可选字段加入,保留旧字段一段兼容期。如果直接把原有 `price` 改名为 `selling_price`,历史数据的解释就会出现断层,分析人员也无法判断旧数据是否具有相同口径。
字段废弃不能只删除代码。应当标记废弃版本、保留迁移说明、确认下游依赖,并在一段时间内继续输出兼容字段或迁移视图。
把库存从字符串改为整数,表面上是质量提升,但历史记录中可能存在“有货”“暂时缺货”“,”等文本。如果没有先定义这些值如何映射,直接改类型会丢失业务语义。
我的做法通常是增加标准字段,保留原始字段,运行一段时间的双写或双算,比较两种结果,再决定是否废弃旧字段。对于关键指标,不建议在一次发布中同时改变字段名、类型和计算口径。
字段标准版本和来源平台适配器版本不能混为一谈。标准模型可能保持不变,但某个平台的页面结构发生变化;也可能来源字段没有变化,业务却新增了价格类型。
| 版本对象 | 变化示例 | 建议记录内容 |
|---|---|---|
| 标准模型版本 | 新增价格类型 | 字段定义、兼容策略、下游影响 |
| 平台适配器版本 | 页面选择器改版 | 来源字段、解析逻辑、上线时间 |
| 映射规则版本 | 枚举值新增 | 旧值、新值和转换关系 |
| 指标口径版本 | 销售额排除优惠分摊 | 计算公式、生效日期、历史是否回算 |
我会特别加入一项“反向查询测试”:让分析人员提出三个业务问题,再检查标准字段是否能直接回答。例如“同一 SKU 一周内价格变化多少”“哪些商品只是页面起售价更低”“库存为空是缺货还是平台未公开”。如果每个问题都需要人工打开页面或写临时清洗脚本,说明字段标准还没有真正落地。
电商数据标准化最容易走偏的地方,是把“统一”理解为所有平台都必须使用相同字段、相同格式和相同层级。实际上,真正可靠的统一标准会保留必要差异:来源 ID 仍然来自不同平台,价格条件仍然可能不同,库存可见性也不一定相同。
标准化的价值在于把这些差异显式化,让系统知道哪些数据可以直接比较,哪些数据只能作为参考,哪些数据必须人工确认。
如果你正在启动一个电商数据抓取项目,可以先选择一个平台和一个核心场景,不要立即扩展到所有类目。建议先建立商品、SKU、价格、库存、来源和抓取时间六类字段,准备一批正常与异常样本,完成映射、校验和回放,再接入分析工具。
如果项目已经运行了一段时间,优先检查三个信号:同一字段是否被不同团队解释成不同含义,价格和库存是否存在大量人工修正,报表是否频繁出现“数据看起来不对但找不到原因”。这些信号通常说明问题不在图表,而在标准层缺失。
我的最终判断是:统一字段标准的验收标准,不是字段数量、代码行数或接口成功率,而是面对一条异常数据时,团队能否说清它来自哪里、代表什么、为什么被接受或拒绝,以及它能否安全地进入下游分析。当字段设计经得起这种追问,抓取系统才真正从“数据搬运程序”变成了可维护的数据基础设施。
我以前以为,只要把不同平台的商品数据抓下来,再把字段名称改成一样,就可以直接合并。实际做跨平台比价时,我发现三个平台都叫“商品 ID”的字段,可能分别对应商品页面、SPU 和 SKU,合并后会出现重复商品和错误统计。
抓取成功只说明程序拿到了数据,不代表这些数据已经具备可比性。真正容易出错的地方,通常不是请求失败,而是字段名称相同、业务含义却不同。
我曾处理过一批跨平台商品样本:平台 A 的 item_id 对应商品页面,平台 B 的 goodsNo 是商家内部货号,平台 C 的 spu_code 则对应一个包含多个规格的 SPU。如果直接统一命名为 product_id,一个商品可能被识别成三个商品,也可能把多个 SKU 错误合并成一条记录。
表面字段可能的真实含义直接合并的风险 商品 ID商品页面编号同一 SPU 的不同页面被重复统计 商品 IDSPU 编号多个 SKU 被压缩成一条数据 商品 IDSKU 编号规格维度丢失,库存和价格错位 因此,我判断字段标准至少要同时定义字段名、业务含义、实体粒度、数据类型、来源、单位和缺失规则。
字段名只是接口层的统一,字段语义和粒度统一,才是数据真正可用的前提。
我在设计商品数据模型时,最困惑的是平台文档里的“商品”和“货品”经常不是同一个概念。尤其是一个商品有多个颜色、容量和包装规格时,我不知道哪些字段应该放在商品层,哪些字段必须下沉到 SKU 层。
判断字段设计是否正确,不能只看结构体能否编译,而要看一条数据是否能准确表达业务对象。我的做法是先问三个问题:这条记录代表一个商品页面、一个 SPU,还是一个可实际售卖的 SKU?价格和库存是否会随规格变化?这个 ID 能否唯一定位到当前记录?
例如,一款手机有黑色 128GB、黑色 256GB 和白色 256GB 三个规格。品牌、系列和商品标题通常属于 SPU 层;颜色、容量、SKU 编号、库存和具体售价则应放在 SKU 层。如果把库存放在 SPU 表中,用户看到的可能是“库存 30”,但系统无法判断这 30 件究竟对应哪个规格。
数据层级适合存储的字段不建议直接存储的字段 商品页面层页面 URL、来源平台、页面标题、抓取时间具体规格库存 SPU 层品牌、系列、类目、通用商品名称某个规格的实际售价 SKU 层规格组合、SKU 编号、库存、售价整组商品的通用描述 我通常会保留三类 ID,而不是强行压成一个 product_id:source_item_id 表示来源页面编号,spu_id 表示标准商品集合,sku_id 表示具体可售单元。
这样虽然字段更多,但后续做价格、库存和销量分析时,错误合并的概率会明显降低。
我曾经把多个平台的价格都清洗成 price,结果发现同一商品出现了“价格上涨”,后来才确认一个平台返回的是起售价,另一个平台返回的是券后价。我想知道,实际项目中应该怎样拆分价格字段,才能避免误导分析结果。
价格是最容易被误读的字段之一,因为页面上的数字不一定代表同一种价格口径。一个页面可能同时展示划线价、日常售价、活动价、券后价、会员价和 SKU 价格区间,全部叫 price 会让后续分析失去解释基础。我在做价格对比时,曾把“从 99 元起”和“当前选中规格 129 元”当成同一个值。
程序没有报错,报表也正常生成,但排序结果完全不可信。后来我把价格拆成类型、金额、币种、适用条件和采集时间,才发现很多所谓的价格波动,其实是价格口径变化。
标准字段建议含义常见风险 list_price页面展示的参考价或划线价可能不是实际成交价 selling_price当前选中条件下的可售价格可能随 SKU、地区或时间变化 coupon_price满足优惠条件后的估算价格未必对所有用户生效 price_captured_at价格被抓取的时间缺少时间就无法解释波动 金额存储上,我更倾向于使用最小货币单位,例如将 129.90 元保存为 12990 分,并在字段名或字段字典中明确单位。
还要保留 price_type、currency 和适用条件。只有这样,系统才能区分“真实降价”和“从起售价切换成具体 SKU 价格”。
我以前维护过一份字段字典,字段名、类型和注释都写得很完整,但数据上线后仍然出现空 ID、负库存和重复 SKU。后来我意识到,文档写得规范并不等于数据真的符合标准,想请教应该怎样把标准变成可执行的验证流程。
字段字典解决的是“应该是什么”,校验规则解决的是“实际是不是这样”。如果没有自动校验,标准通常只能停留在文档层面,采集程序一旦遇到页面改版或异常返回,错误数据就会悄悄进入主表。我通常把校验分成五层。第一层是类型和格式,例如价格必须是整数金额,时间必须带时区;
第二层是完整性,例如来源平台和来源 ID 不能为空;第三层是唯一性,例如同一来源下 SKU 编号不能重复;第四层是范围,例如价格和库存不能为负;第五层是关联一致性,例如 SKU 必须能找到对应的 SPU。
校验类型示例规则失败处理 完整性source_platform 和 source_item_id 不为空拒绝入库 格式金额为整数分,时间符合 ISO 8601进入修复队列 范围库存不小于 0,折扣率处于合理区间标记异常 关联SKU 必须关联有效 SPU暂存并待确认 统计字段非空率、重复率和枚举异常率超过阈值暂停批次发布 开发实现时,可以让标准模型和校验逻辑同时存在。
例如 Go 结构体负责类型和序列化,校验函数负责业务规则,字段字典负责解释和版本管理。特别要注意,指针字段只能区分“没有值”和“数值为零”,并不会自动判断库存是否合理、价格是否匹配或 SKU 是否关联正确。我建议每批数据都输出质量报告,而不是只记录抓取成功率。
至少观察主键非空率、重复率、价格异常率、枚举未映射数量和关联失败数量。一个批次即使抓取成功率达到 99%,如果 SKU 关联失败率为 15%,它仍然不应该直接进入分析库。





读者评论
文章把“抓取成功”和“数据可用”区分开来,这一点很实用。尤其是商品页面、SPU、SKU的层级混用,确实容易造成重复统计,保留来源ID和内部关联ID是比较稳妥的做法。
价格字段拆分得比较细,能看出不同业务场景的差异。页面起售价、基础销售价和券后价不能直接横向比较,补充价格条件与观察时间后,分析结果会更可靠。
库存空值不等于缺货,这个提醒很有价值。实际项目中还应结合接口权限、页面加载状态和库存可见性判断,否则把空值转成0,可能会直接影响补货决策。
文中关于保留原始字段、同时生成标准字段的做法值得参考。全部转成字符串虽然便于入库,但会损失金额、数量和时间的计算能力,后续报表处理成本反而更高。
文章对字段标准的讨论比较全面,但示例中的验证比例属于情景模拟,不能直接当作普遍行业数据。落地时还需要根据平台规则、业务口径和历史样本建立自己的校验阈值。