

数据库存:仓储系统团队避坑指南:做历史追溯时别忽略设计难扩展
仓储系统第一次被要求“查历史”时,很多团队都会发现:库存表里明明有商品、批次、数量和更新时间,真正要回答问题却仍然无从下手。业务问的不是“现在还剩多少”,而是“这批货什么时候进来的、经过哪些库位、被哪张单据扣减、为什么在盘点后变成这个数、是谁做过人工调整”。如果系统只保存最终库存,而没有保存足以解释结果的历史事实,第一次复杂追溯需求往往就是数据库重构的开始。
我在仓储系统数据模型评审中,最常见的误判不是索引没建好,也不是数据库类型选错,而是团队一开始把“当前状态”“业务单据”“库存变更事件”和“操作审计”混成了一类数据。短期看,表少、开发快;长期看,新增加一个批次维度、一个库存状态或一种调整流程,都可能牵动核心表结构、历史数据和所有查询接口。
库存余额表通常服务于高频业务:判断可用库存、锁定数量、生成拣货任务、展示仓库看板。它的核心目标是快速给出当前结果,因此表里往往是商品、仓库、库位、批次和当前数量等字段。
但历史追溯需要回答的是另一组问题:某个时间点的库存是多少?数量变化由哪些动作造成?动作来自哪张单据?操作发生在什么时间?数据经过了几次冲正、补录或重试?这些问题不能仅靠当前余额表回答。
当前状态是历史业务动作累计后的结果,历史事件则是解释这个结果的依据。把二者放在同一张表里并不是绝对错误,但如果没有清晰的数据职责、变更规则和关联链路,当前表很快会变成既承担在线交易,又承担历史审计,还承担报表查询的“万能表”。
很多团队把可扩展性理解为“以后还能继续加字段”。这只是最表层的扩展性。仓储系统更关键的扩展性,是新需求到来时,原有数据是否仍然能够被解释。
例如,系统最初只按商品和仓库管理库存,后来增加批次;再后来增加货主、质量状态、库位、序列号和保质期。每增加一个维度,库存的唯一性就可能发生变化。原来“商品加仓库”唯一的一条余额记录,可能变成“货主加商品加批次加仓库加库位加库存状态”的组合。
如果历史流水没有保留这些维度,后续不是简单加字段,而是要面对历史数据无法补齐、旧接口语义不一致、库存汇总口径变化和报表结果不一致等问题。
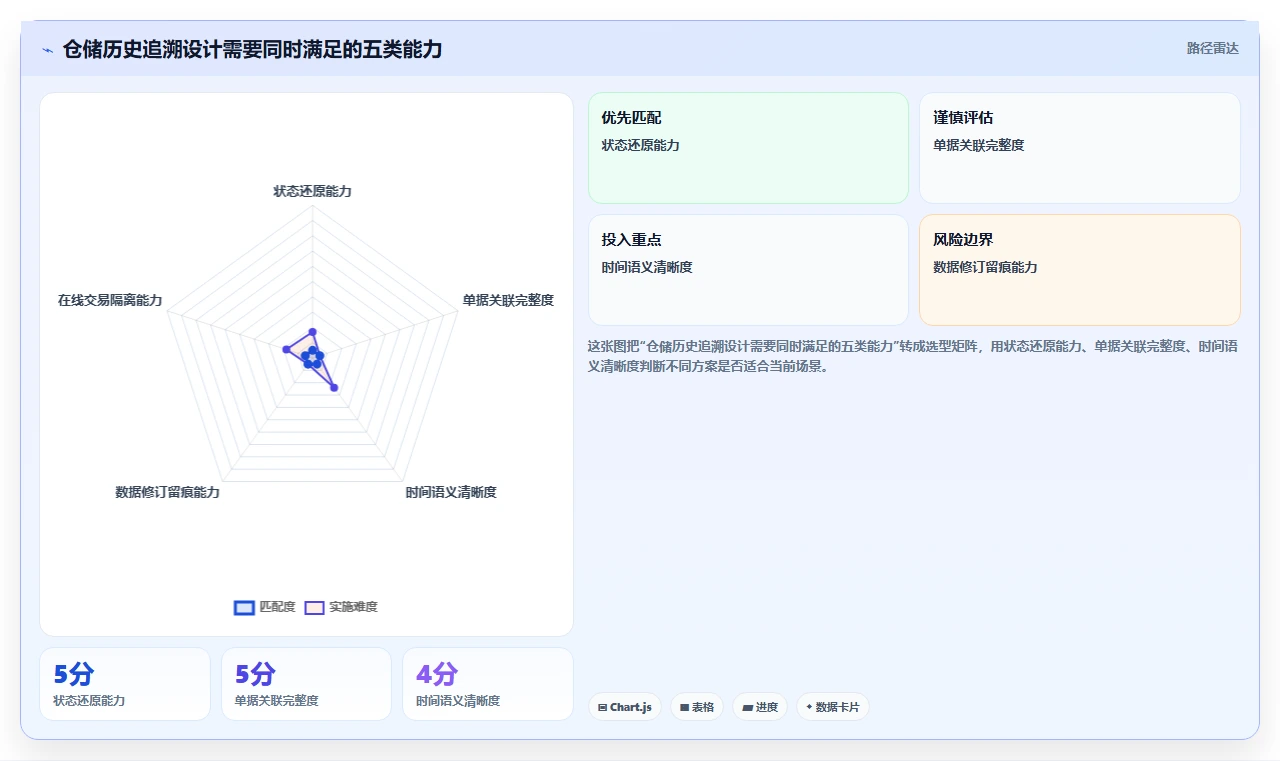
在设计表结构前,我通常要求团队先写出五个必须回答的问题。它们比“使用哪种数据库”更能决定后续方案。
这五个问题中,只要有两个无法回答,说明团队还没有完成历史追溯设计,而只是完成了几张业务表的设计。
看起来,入库就是库存加一,出库就是库存减一。但真实仓储业务中的一次变化,可能同时涉及货主、批次、库位、库存状态、包装单位、锁定状态、质量状态和来源单据。
例如,一批商品从收货暂存区移动到正式库位,数量没有变化,但位置变了;一批待检商品转为合格品,数量没有变化,但可用状态变了;一次订单分配可能减少可用量,却增加锁定量;一次盘点差异可能产生调整数量,但不能简单替换原来的库存事实。
如果系统只记录“库存从 100 变成 96”,它记录了结果,却没有说明减少的 4 件来自哪一批、哪个库位、哪张出库单,也没有说明是正常出库、盘亏还是人工修正。
系统上线初期,业务方通常只关心三个画面:当前库存、入库单列表和出库单列表。运行一段时间后,需求会逐渐变成“查某个时间点”“查某个批次”“查某个操作人”“查某个订单影响了哪些库存”“查一件商品曾经经过哪些库位”。
这些需求并不一定来自技术团队,而是来自客户投诉、质量召回、盘点差异、供应商对账、仓库责任认定或经营分析。它们的共同特征是:查询条件不断增加,时间范围不断扩大,且需要把多类数据串成一条可解释的链路。
因此,历史追溯不能只按当前需求做最小设计。正确做法不是无边界地保存所有字段,而是提前明确哪些事实必须不可变、哪些状态可以重算、哪些维度属于核心查询条件。
仓储系统中至少存在四种时间:业务发生时间、设备采集时间、系统接收时间和数据库写入时间。异步接口、消息队列、离线补录和人工审核都会让它们出现差异。
例如,仓库人员上午 10 点完成了实物盘点,设备在 10 点 02 分上传数据,系统因为网络问题在 10 点 15 分写入数据库,主管在 11 点完成审核。如果团队只保存一个 updated_at,后续无法判断这次盘点究竟发生在什么时候。
时间字段不是越多越好,但关键时间语义必须明确。我建议至少区分业务发生时间和系统落库时间;有审批流程时,再单独记录审核时间。对于设备采集型业务,还应保留设备时间或原始报文时间,避免后续追查时只能依赖服务器时间。
许多团队担心事件表会增加存储量,于是选择在库存表上直接更新数量,并通过数据库操作日志“以后再查”。这种方案的问题在于,数据库审计通常只能说明某个字段被谁改过,不一定能说明这次修改对应哪张业务单据、改变了哪个库存对象、是否经过业务校验。
更严重的是,数据库日志可能受保留周期、权限、归档策略或数据库迁移影响。它是技术层面的证据,不天然等于业务层面的追溯链路。
历史事实的存储成本通常可以通过分区、归档、冷热分层和读模型控制;而历史事实缺失后,往往只能依靠人工对账、接口日志和人员回忆拼接。二者不是同一量级的成本。
这是最容易被接受的方案,因为实现成本低,页面也能显示“最后由谁修改”。但它只能回答最后一次修改,不知道中间发生过什么。
假设某批次库存依次发生入库 100 件、出库 20 件、调拨 30 件、盘点增加 2 件,最终余额为 52 件。如果余额表只保存最终数量和最后操作人,前面三次变化都会被覆盖。即使把最后修改人扩展为多个字段,也无法支持任意时间点回放。
改进方式是保留当前余额表,同时追加库存变更事实。余额表负责快速读取,历史表负责解释变化,两者通过业务对象、事件编号或来源单据建立关联。
大宽表看上去便于查询,但不同业务动作的字段语义并不相同。入库可能需要供应商和收货单,出库需要订单和拣货任务,盘点需要盘点批次和差异原因,调拨则需要来源库位和目标库位。
把这些字段全部放在一张表里,通常会出现大量空字段、字段含义依赖业务类型、校验规则复杂和索引难以兼顾等问题。更麻烦的是,新业务类型加入后,原有接口可能把空值误当成默认值。
更稳妥的做法是:用统一的事件主表承载通用事实,用业务单据表承载具体流程,用明细或扩展表保存某类业务独有的信息。统一不是所有数据都挤进一张表,而是统一事件身份、时间、来源和关联规则。
数据库更新时间适合判断记录何时被写入或修改,不适合代表业务动作何时发生。尤其在异步消费、批量导入和人工补录场景中,二者可能相差数分钟、数小时甚至数天。
如果盘点报告按落库时间统计,而库存结算按业务发生时间统计,就会出现报表对不上账。团队通常会把问题归结为“数据延迟”,但根因其实是时间口径没有被建模。
建议所有涉及库存变化的事件明确记录:
没有来源单据的流水,往往只能证明“库存变了”,却不能证明“为什么变”。没有幂等标识的流水,则无法判断重复请求是两次真实出库,还是同一条消息被消费了两次。
我建议每次库存变化至少具备一个业务来源标识和一个请求幂等标识。来源标识用于业务追溯,幂等标识用于技术防重。两者不能混为一谈,因为同一张出库单可能包含多条明细,也可能被拆成多个仓内作业。
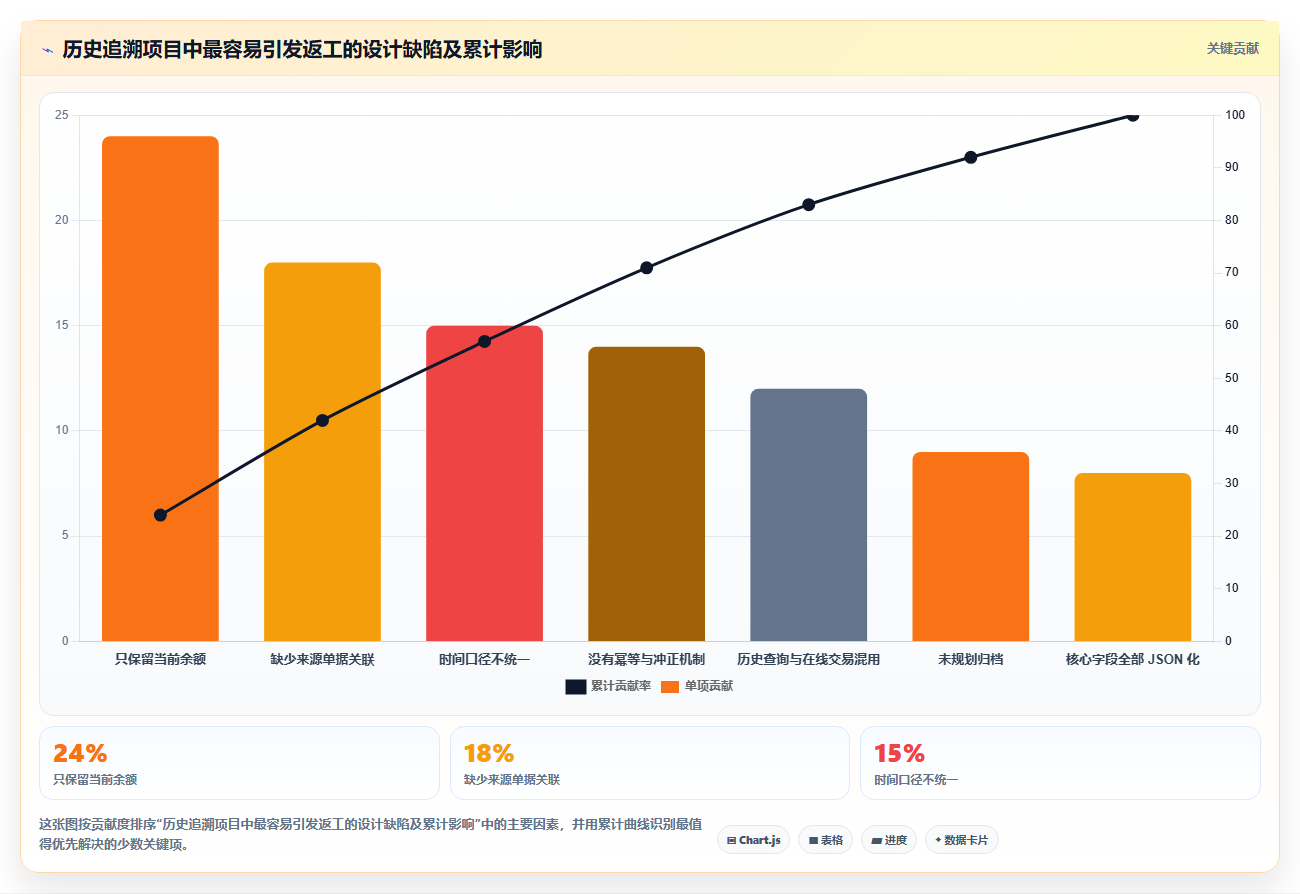
仓储业务中难免会出现录入错误、接口错传和盘点修正。最省事的做法是直接把错误流水改正确,但这会让系统失去“原始事实”与“后续处理”的区别。
例如,一条错误流水把批次 A 误记成批次 B。直接修改后,系统看起来没有错误,但审计人员无法知道曾经发生过一次错误归属,也无法解释相关报表为什么在某个时点发生变化。
更可靠的方式通常是保留原记录,再追加一条冲正事件或修订事件。这样既能让当前结果正确,也能保留完整处理过程。对于需要强审计的行业,还应记录修订原因、审批人和关联工单。
库存变更是写入密集型业务,追溯查询则常常是范围查询和多条件关联。两类访问模式混在同一张超大表中,容易出现历史查询扫描大量数据、索引膨胀、锁竞争和在线交易延迟。
团队常见的错误是先把所有字段写进去,等查询慢了再“补索引”。但索引不是免费的。每增加一个高基数字段的组合索引,都会增加写入维护成本、存储占用和更新压力。
索引应由真实查询场景驱动。例如,按批次追溯与按单据追溯通常需要不同索引;按时间范围查全仓变更,则要优先考虑时间分区、数据归档和专用读模型,而不是给所有字段都建立联合索引。
历史数据一旦进入主库,很多团队就不愿意删除,但“永远在线”并不等于“永远放在交易库”。交易库需要稳定写入和可预测查询,历史库更强调保留、检索和审计。
归档前必须回答几个问题:哪些数据可以迁移?归档后是否还要支持秒级查询?主库是否保留摘要?跨库追溯如何关联?归档数据是否需要防篡改?如果这些问题没有答案,系统可能在数据量增长后被迫停机迁移。
JSON 适合承载变化快、低频查询或来源不稳定的附加属性,但不适合替代核心业务模型。批次、仓库、库位、货主、状态、发生时间和数量等字段,通常应保持结构化,因为它们要参与约束、聚合、索引和一致性校验。
如果把核心字段全部放进 JSON,短期确实减少了改表次数,长期却可能增加数据类型不一致、查询性能不可控、字段约束缺失和历史数据治理困难等问题。
当前状态层保存系统此刻认为有效的库存结果,例如可用数量、锁定数量、待检数量和冻结数量。它可以通过实时更新、事件计算或定时汇总产生,但必须明确谁是权威来源。
这张表的设计重点是查询稳定和更新一致。常见做法是围绕货主、商品、批次、库位和库存状态定义业务唯一键,再针对最频繁的库存读取建立索引。
当前状态层不需要保存所有历史细节,也不应该承担复杂的审计职责。它只需要能够被历史事件核对,并在发现差异时知道如何重算或修复。
入库单、出库单、调拨单、盘点单和退货单描述的是业务意图。它们通常包含申请人、审核状态、来源订单、供应商、客户、作业波次和业务原因。
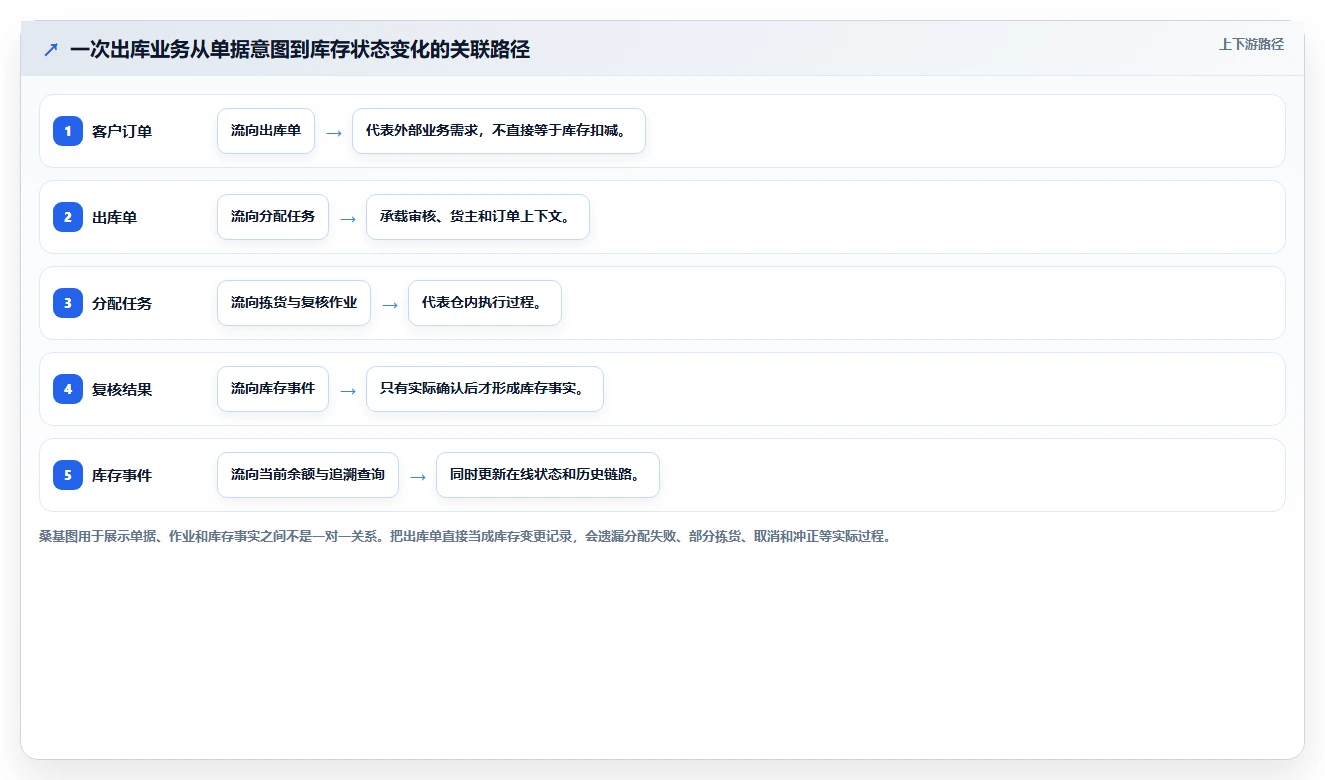
业务单据并不等于库存变化。一个出库单可能先创建、后审核、再分配、再拣货、再复核,最终才形成实际扣减。一个调拨单也可能拆分成多个仓内动作。
因此,不能只用单据状态替代库存历史。单据说明“要做什么”,库存事件说明“实际发生了什么”。两者需要建立关联,但不应被当成同一类数据。
事件事实层记录库存变化或库存属性变化。它应尽量表达已经发生的业务事实,而不是保存某个瞬间的页面状态。
一条事件通常可以包括事件编号、事件类型、业务对象、数量、单位、来源单据、来源明细、发生时间、落库时间、仓库、库位、货主、批次、序列号、前状态、后状态、操作主体和幂等键。
事件是否保存前后快照,要看追溯需求。如果业务主要关心数量变化,可以保存变更量和变化前后余额;如果业务需要完整回放状态,则可能需要更细粒度的事件或版本记录。
审计记录关注的是责任和操作,不一定等于库存业务事实。管理员修改一个单据备注,可能需要审计;仓库人员完成一次出库,也需要业务事件;两者的记录目的不同。
审计数据建议至少记录操作者、角色、请求来源、客户端或设备、操作时间、目标对象、修改前值、修改后值和原因。对于敏感字段,还要考虑脱敏展示和访问权限。
四层职责的价值,不在于一定要建四张表,而在于让团队知道每类数据由谁产生、服务什么查询、能否修改以及如何保留。
下面用伪 SQL 展示一种职责分离思路。字段只是示例,真实项目应根据追溯对象和数据库能力调整。
CREATE TABLE inventory_balance (
owner_id           BIGINT NOT NULL,
warehouse_id       BIGINT NOT NULL,
location_id        BIGINT NOT NULL,
sku_id             BIGINT NOT NULL,
lot_id             BIGINT,
inventory_status   VARCHAR(32) NOT NULL,
available_qty      DECIMAL(18, 3) NOT NULL DEFAULT 0,
locked_qty         DECIMAL(18, 3) NOT NULL DEFAULT 0,
updated_at         TIMESTAMP NOT NULL,
PRIMARY KEY (
owner_id, warehouse_id, location_id,
sku_id, lot_id, inventory_status
)
);
CREATE TABLE inventory_event (
event_id           BIGINT PRIMARY KEY,
idempotency_key    VARCHAR(128) NOT NULL,
event_type         VARCHAR(32) NOT NULL,
owner_id           BIGINT NOT NULL,
warehouse_id       BIGINT NOT NULL,
location_id        BIGINT,
sku_id             BIGINT NOT NULL,
lot_id             BIGINT,
serial_no          VARCHAR(128),
delta_qty          DECIMAL(18, 3) NOT NULL,
before_qty         DECIMAL(18, 3),
after_qty          DECIMAL(18, 3),
source_doc_type    VARCHAR(32),
source_doc_id      VARCHAR(64),
business_time      TIMESTAMP NOT NULL,
received_at        TIMESTAMP NOT NULL,
recorded_at        TIMESTAMP NOT NULL,
operator_id        BIGINT,
correction_of      BIGINT,
UNIQUE (idempotency_key)
);
这个示例没有试图把所有业务字段都塞进事件表,而是保留了几个关键线索:事件类型、库存对象、变更数量、来源单据、业务时间、幂等键和修订关系。真正重要的是这些线索能够串起来,并且规则在所有库存变化入口中保持一致。
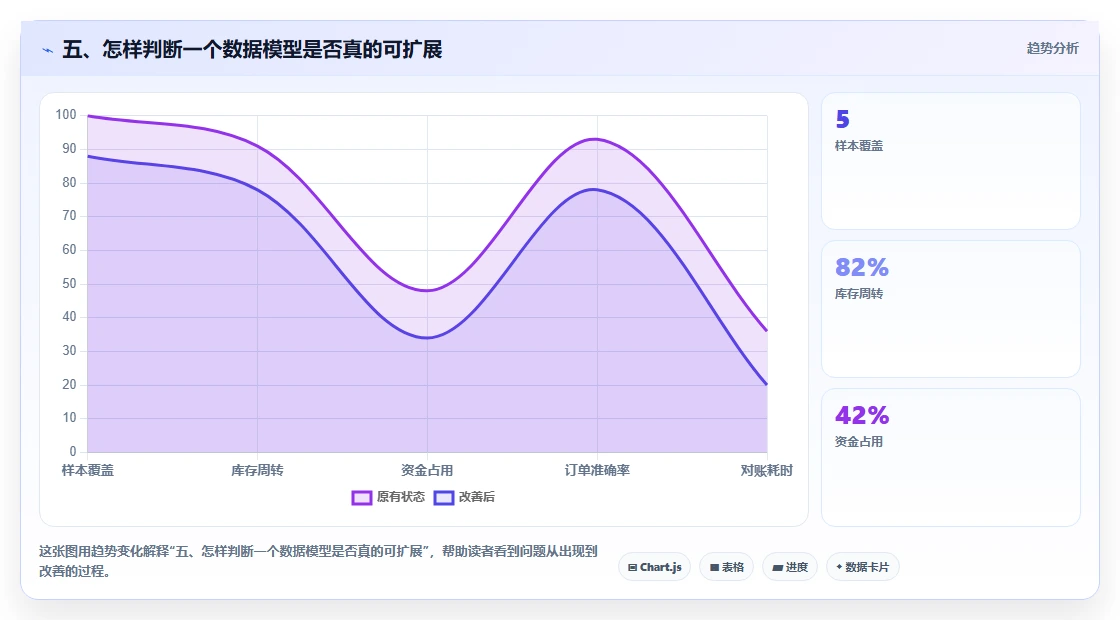
假设系统已经支持入库、出库和调拨,现在要增加“库存状态转换”。如果新增功能必须修改所有历史记录、重新解释旧字段,说明原模型把业务类型和库存结果绑定得太紧。
较好的模型应允许新增事件类型,同时保留统一的事件身份、对象标识、数量语义和来源关联。新类型可以扩展专属属性,但不应改变旧事件的含义。
这里的“可扩展”不是完全不改表,而是改动边界可控、历史语义不被破坏、旧接口可以平稳过渡。
如果系统未来可能按批次、序列号、库位、货主或质量状态追溯,就要在初期确定哪些维度是核心业务对象,哪些只是展示属性。
一个常见错误是上线时不保存库位,因为当时业务只关心仓库总量。后来发生货损或先进先出争议,业务要求查询货物经过的每个库位,团队却发现历史记录没有位置信息,只能从作业日志中零散拼接。
我会把“未来新增维度是否需要补写历史”作为评审重点。凡是无法从旧数据推导出来、且可能用于责任认定或质量追踪的维度,都不应轻易省略。
事件模型不能只追求“记录很多”,还要具备可校验性。理想情况下,在同一业务边界内,当前状态可以由初始库存加上有效事件计算得到。
实际系统会存在期初导入、历史迁移、冲正和人工调整,因此不一定要求每次都从零回放。但至少要能通过日结、批次核对或指定时间窗口,对余额和事件进行差异检查。
如果余额表和事件表长期各自变化,没有校验任务,最终会出现“余额看起来正确、流水也看起来完整,但两边无法互相证明”的情况。
仓储系统经常与手持终端、自动化设备、订单系统和运输系统交互。网络抖动会导致重复提交,消息重试会导致重复消费,批量补录会导致事件晚于后续事件到达。
因此,设计时至少要明确:
如果系统采用异步事件处理,不能只讨论消息吞吐量,还要讨论重复、丢失、乱序和补偿。历史追溯最怕的不是一条记录慢一点,而是记录无法证明自己是否真实、完整和有效。
“支持历史查询”不是一个足够明确的需求。至少要把查询拆成具体场景:按批次追踪、按序列号追踪、按单据追踪、按时间点还原、按库位查看轨迹、按操作人查询调整、按库存状态分析。
不同查询场景对应不同的数据组织方式。按序列号追踪通常需要高选择性的对象索引;按时间点还原可能需要事件排序和快照;按全仓时间范围分析则可能更适合专门的分析表或数仓。
在不知道真实查询条件前,直接决定分库、分表或引入搜索引擎,往往只是把不确定性转移到更复杂的基础设施上。
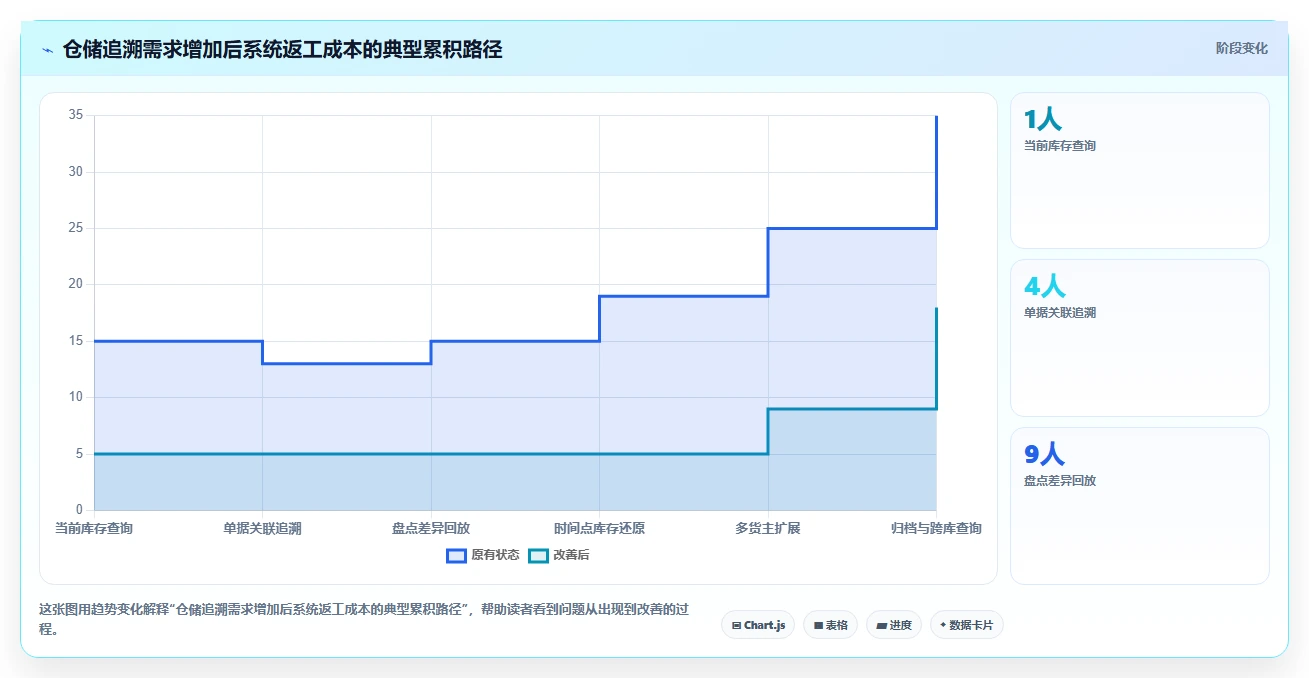
下面是我在类似项目评审中经常看到的一种结构:库存表按仓库、商品和批次汇总,入库单和出库单分别保存业务单据,库存变化直接更新余额。系统上线时,业务主要查看当前库存和单据状态,因此没有立即暴露问题。
这种设计在业务简单、历史要求低、数据规模有限时并非完全不能用。问题在于,团队往往没有明确它的适用边界,后来又在原结构上不断叠加“最后操作人”“调整原因”“上次库存”等字段,试图把它变成历史系统。
某仓库出现盘点差异,业务希望知道:差异是在收货、上架、拣货、移库还是人工调整环节产生的。团队先查库存表,再查单据表,最后发现单据只表示业务流程,无法证明实际扣减和库位变化。
为了查清问题,开发人员临时从应用日志、设备日志和数据库备份中拼接数据。结果是同一件事在不同系统中的时间、数量和编号不完全一致,需要业务人员逐笔确认。
这类返工的关键不是少了一张日志表,而是系统没有建立统一的事件身份。每个系统都记录了自己的动作,却没有一个共同的关联键来说明它们是否属于同一次库存变化。
随后业务又提出按月末、日末和盘点时点查看库存。团队尝试从当前余额倒推历史,但此前的出库、调拨和盘点调整没有保留完整的变化量与业务时间,导致只能从部分单据推算。
如果历史事件完整,时间点还原可以按照事件时间排序,从期初状态逐步应用有效变化;如果只有当前余额和零散单据,就只能得到一个“估计值”,而不是可审计的历史状态。
当仓库从自营库存扩展到多货主库存后,原有“商品加仓库”粒度不够,团队需要改造唯一键、接口参数和汇总逻辑。更棘手的是,旧历史流水没有货主字段,无法严格判断过去的库存变化属于哪个主体。
这说明扩展性问题通常不是在新增功能上线时才产生,而是在第一次建模时就已经决定。后续需求只是把原本隐藏的设计债务暴露出来。
很多团队会把返工原因归结为“业务需求变化太快”。需求变化确实不可避免,但成熟设计的目标并不是预测所有需求,而是把变化隔离在可控边界内。
对于仓储历史追溯,最应该提前稳定的是四件事:事件如何编号、业务对象如何标识、时间如何定义、修订如何表达。业务类型和扩展属性可以变化,但这四件事如果频繁变化,后续迁移成本会非常高。
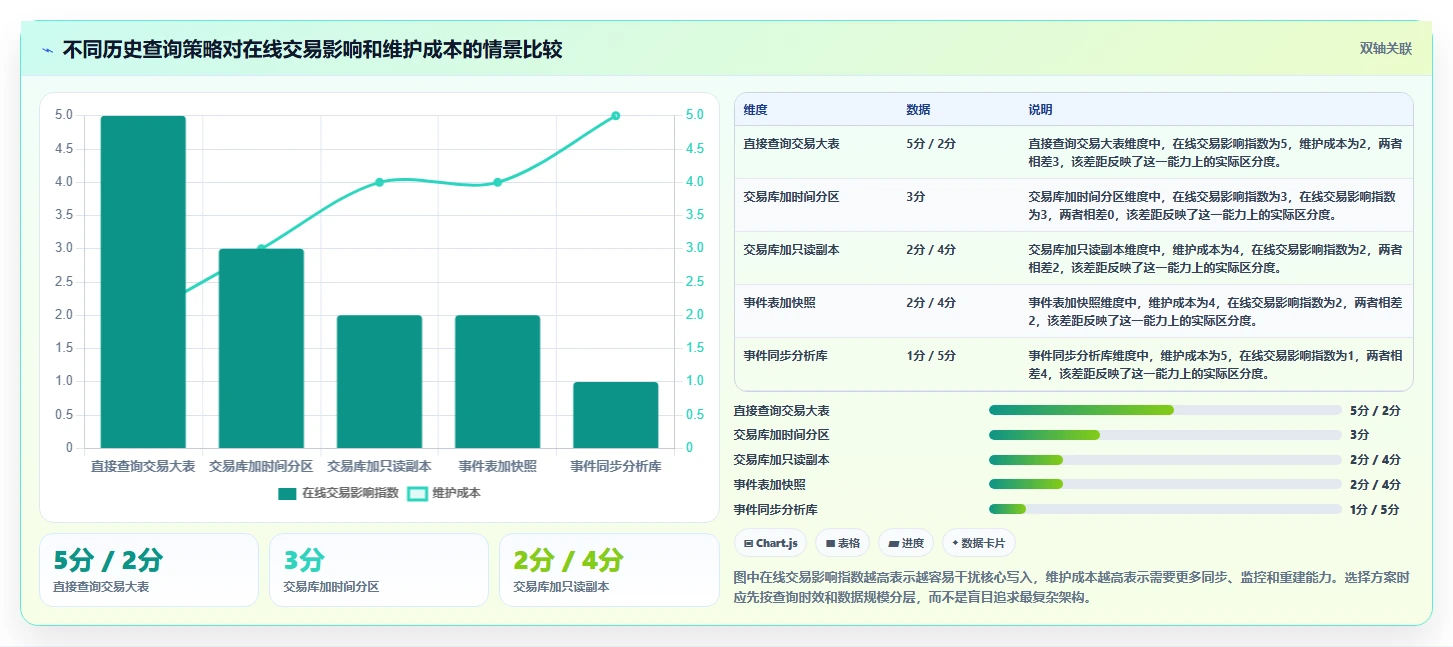
不是所有历史查询都需要同样的时效。仓库主管可能希望几秒内查出某批次去向,财务部门可能接受分钟级甚至小时级的库存变动报表,管理层则更关心周期趋势和异常分布。
如果把所有查询都压在交易库上,系统会被迫用一套表结构同时满足强一致写入、明细追溯、复杂聚合和长期分析,最终每一种场景都不够好。
我通常建议把查询分为三类:
第一类可以优先优化交易库索引和读副本;第二类需要事件、快照或专用回放模型;第三类通常更适合进入分析库或数据集市。
当历史表变大时,团队经常直接讨论分库分表,但这不是唯一方案,也不是最先要做的事。首先要了解单日事件量、数据保留周期、查询时间范围、写入峰值和最常见的过滤条件。
如果历史表主要按发生时间查询,时间分区可能比复杂的水平分片更容易维护;如果查询主要按序列号或批次定位,则需要围绕对象键设计索引或读模型;如果数据主要用于统计,直接同步到分析库可能更合理。
分库分表解决的是规模边界,不解决数据语义混乱。如果事件没有来源、时间不可信、重复无法识别,拆成十个库也不会让历史变得可追溯。
纯事件回放的优点是事实完整,缺点是当事件量很大时,从系统起始时间逐条计算会变慢。一个常见优化是按日、按月或按关键业务节点生成库存快照,查询历史状态时从最近快照开始回放。
快照不是替代事件,而是事件的加速结构。快照生成后仍应保留生成时间、覆盖范围、事件水位和校验结果,避免快照本身成为无法解释的黑盒。
例如,查询某批次在 6 月 30 日 18 点的库存,可以先读取 6 月 30 日 0 点的快照,再应用当天截至 18 点的有效事件。这样既保留了回放能力,也避免每次都从最早历史开始计算。
历史追溯读模型可以按照查询场景预先组织数据,例如批次轨迹表、序列号轨迹表、单据影响表或库位变更表。但每增加一个读模型,就增加一套同步、校验和修复机制。
因此,不能因为“以后可能会查”就复制所有数据。读模型应有明确的使用频率、响应目标和重建方式。如果某个读模型无法从事件事实重新构建,就要谨慎评估它是否会成为新的数据孤岛。
普通标品仓的核心追溯对象通常是商品、仓库、库位和单据。若商品没有批次管理,也不需要单件序列号,就不必为了“完整”而保存过细的数据。
这类场景可以采用库存余额加库存事件的基础模型,重点保证入库、出库、调拨、盘点和退货都有统一事件编号,并能关联来源单据和操作主体。
取舍在于:减少过细事件可以降低存储和写入成本,但会牺牲部分单件级追踪能力。只要业务责任边界明确,这种取舍通常是合理的。
食品、药品、化工原料和部分制造业物料,通常需要按批次追溯来源、库存状态和流向。批次不能只作为一段展示文本,因为它可能涉及生产日期、有效期、供应商、质检结果和召回范围。
批次追溯需要保证入库、拆分、合并、移库、出库和退货过程中的批次信息连续。尤其要注意批次拆分和合并:如果一个批次被分装成多个包装单位,系统需要保留父子关系或等价的转换记录。
建议将批次作为独立主数据或业务对象管理,并在库存事件中保留稳定的批次标识,而不是依赖批次名称。批次名称可能被修正,稳定标识则用于关联历史。
高价值设备、电子产品和需要售后保修的商品,常常按序列号追踪。此时“数量变化”不够,因为一件商品可能经历收货、检测、维修、换货、出库和退回等多个状态。
序列号模型应关注单件生命周期和状态转移。数量汇总可以由序列号状态计算,但不能用一个总数量反过来替代序列号事实。
这类场景的存储、索引和查询成本更高,团队应提前确认是否真的需要全链路单件追踪。若只是出厂后需要保修查询,而仓内不要求每个动作都留痕,可以采用分阶段追踪,避免把所有环节都设计成高成本模型。
冷链仓库不仅要知道货物数量,还要关注温度、质检状态、隔离状态和有效期。库存从“待检”变成“合格”并不一定发生数量变化,但它会直接影响可用库存和出库决策。
因此,质量状态变化也应被视为可追溯事件。温度等连续采集数据则不一定全部写进库存事件表,可以通过设备数据表、采样记录和异常事件关联起来。
这里的设计取舍是:库存事件保存关键状态转变,设备系统保存高频原始采样,二者通过批次、容器、设备或时间窗口关联。把每条温度采样都当作库存流水,会让交易库承担不必要的数据压力。
多货主场景中,货主不仅是一个查询条件,还可能是数据隔离、计费、责任认定和结算的边界。历史事件必须稳定记录货主归属,且要明确货主变更、寄售、代管和库存转移的处理规则。
如果货主字段在历史表中缺失,后续很难准确还原某段时间的库存责任。即使当前余额已经按货主拆开,旧事件也可能无法分配,导致历史报表只能标记为“未知来源”。
| 业务类型 | 主要追溯对象 | 建议重点保留 | 主要成本 | 不宜过度设计的部分 |
|---|---|---|---|---|
| 普通标品仓 | 商品、库位、单据 | 数量变化、来源单据、操作时间 | 历史表和查询索引 | 不必默认做到单件级追踪 |
| 批次管理仓 | 批次、有效期、质量状态 | 批次流转、拆分合并、状态变更 | 批次关系与回放逻辑 | 不要用可变名称代替稳定批次标识 |
| 序列号仓 | 单件序列号 | 单件状态、位置、维修和换货轨迹 | 数据量、索引和查询延迟 | 不必让所有商品都采用序列号模型 |
| 冷链质量仓 | 批次、容器、质量状态 | 状态变化、异常温度、隔离与放行 | 设备数据与库存事件关联 | 不要把高频原始采样全部写入交易流水 |
| 多货主仓 | 货主、库存责任、单据 | 货主归属、权限边界、转移关系 | 数据隔离、计费和历史迁移 | 不能上线后才补货主维度 |
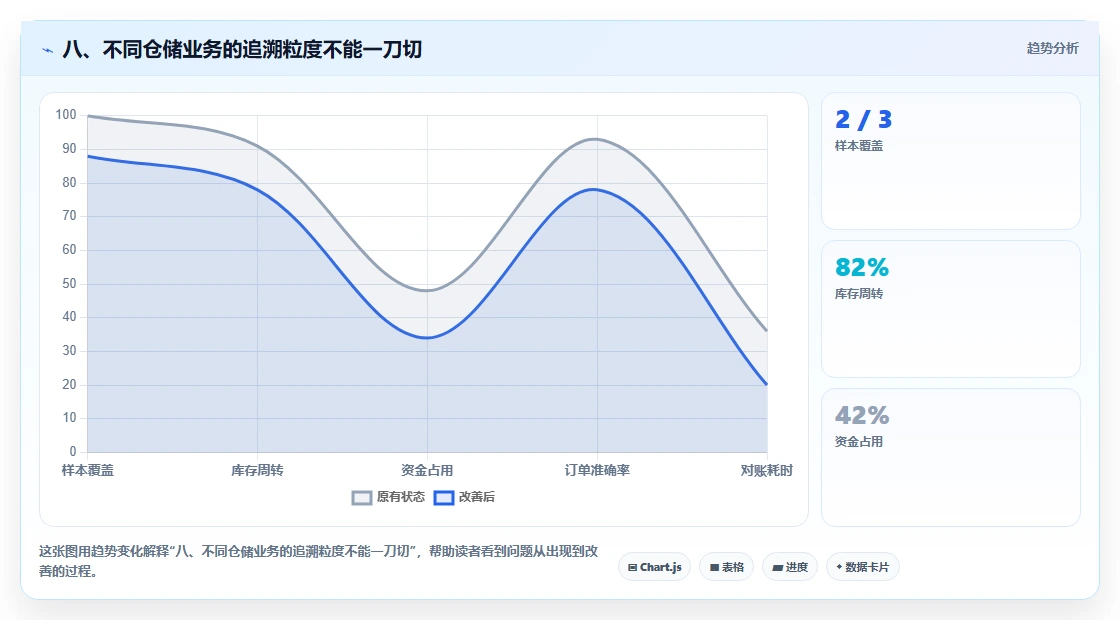
余额表与事件表不能只是“理论上相关”。系统应建立可执行的核对关系,例如指定商品、批次、库位和时间范围内,期初余额加有效事件变更后,应与期末余额一致。
这里的“有效事件”需要排除被冲正的原始事件,或者按照事件状态和修订关系计算。核对逻辑必须在设计阶段明确,而不是等出现差异后临时编写脚本。
单据创建不等于库存已经变化,审核通过也不一定等于仓内作业完成。系统必须明确什么时点形成库存事实。
例如,出库单审核后可以产生锁定事件,但只有复核完成后才产生实际扣减事件。若团队把“订单审核”直接视为“库存出库”,就会在取消、缺货和部分发货时产生历史歧义。
建议为不同库存动作定义明确的生效条件,并在事件中保存业务状态。这样,追溯页面可以区分“计划动作”“已锁定”“已执行”和“已冲正”,而不是把所有状态都混成一个数量。
库存差异并不总是数据库错误。有时是单位换算不同,有时是包装层级不同,有时是业务时间和入账时间不一致,还有时是某些冻结库存没有纳入可用量。
因此,核对系统不能只输出“相差 10 件”,还应给出差异来源:事件缺失、重复消费、时间窗口不同、单位换算、状态口径或人工调整。只有能解释差异,核对才真正有价值。
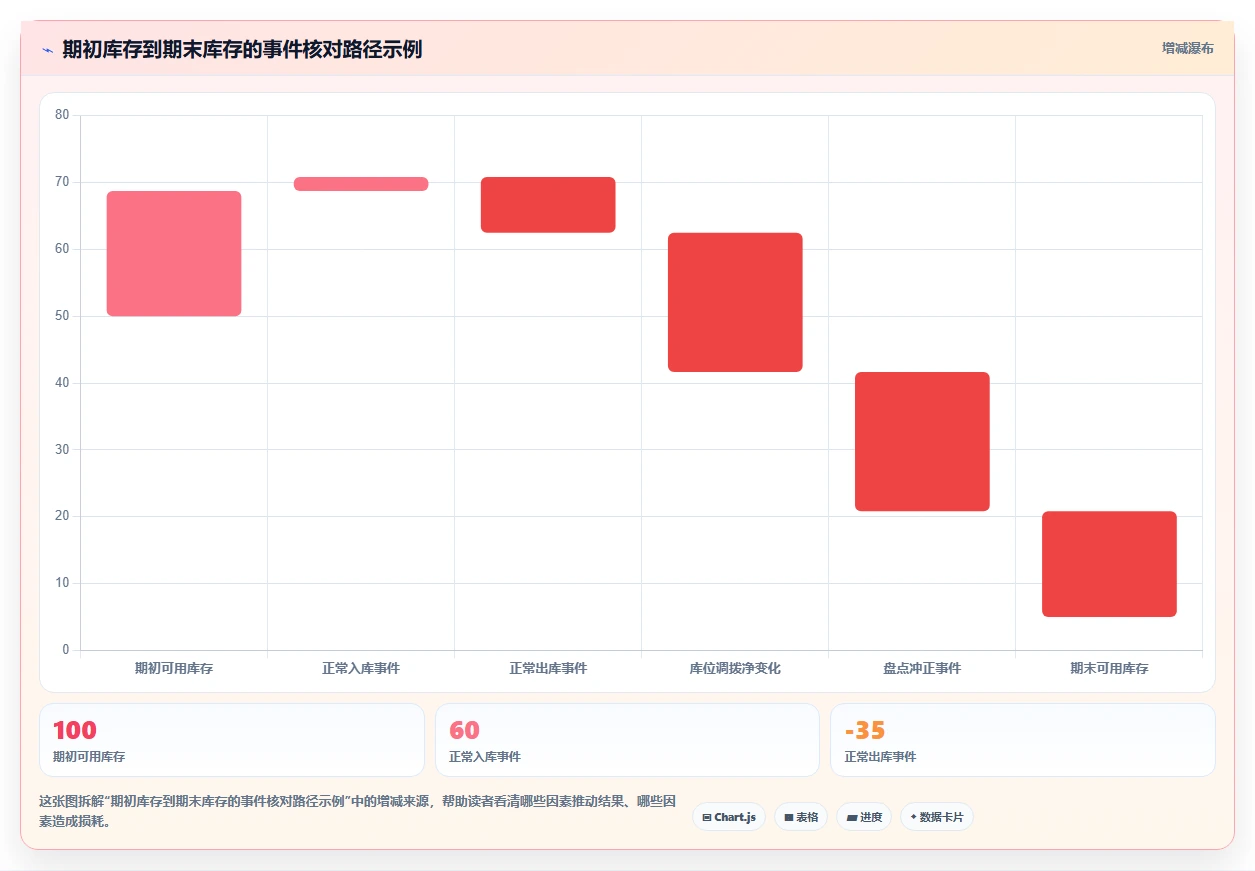
仓储系统上线验收时做一次数据核对远远不够。接口重试、人工补录、批量导入和数据库故障都可能在运行过程中产生异常。
建议按业务重要程度安排核对频率:核心库存可以日核对,关键批次或质量敏感库存可以按事件实时校验,经营分析数据则可以按日或按小时核对。发现差异后,要能生成待处理任务并记录处理结论。
如果核对结果只发一封邮件,没有责任人、处理状态和修复留痕,系统仍然无法形成闭环。
历史查询性能不能用一个统一数字判断。按序列号查一件商品的轨迹,与按仓库和季度统计所有库存变化,不是同一种查询。
压测前应明确查询目标,例如:单个序列号明细查询、单个批次三个月轨迹、单张出库单影响的库存对象、某个时点的仓库库存、按操作人查询人工调整。每个场景都要定义并发量、数据范围、响应时间和可接受的超时比例。
只用连续、干净、按时间顺序的正常数据压测,会低估真实系统的复杂度。历史追溯最耗资源的场景,往往来自跨表关联、冲正链路、重复事件、跨库查询和大范围时间过滤。
测试数据至少应包含:
平均响应时间容易掩盖极端慢查询。仓库高峰期真正影响体验的,往往是 P95、P99 延迟、数据库连接池占用、锁等待、磁盘读写和缓存命中率。
建议将在线库存交易与历史查询分别监控。历史追溯即使偶尔较慢,也不应让出库扣减、库存锁定和设备回传持续排队。
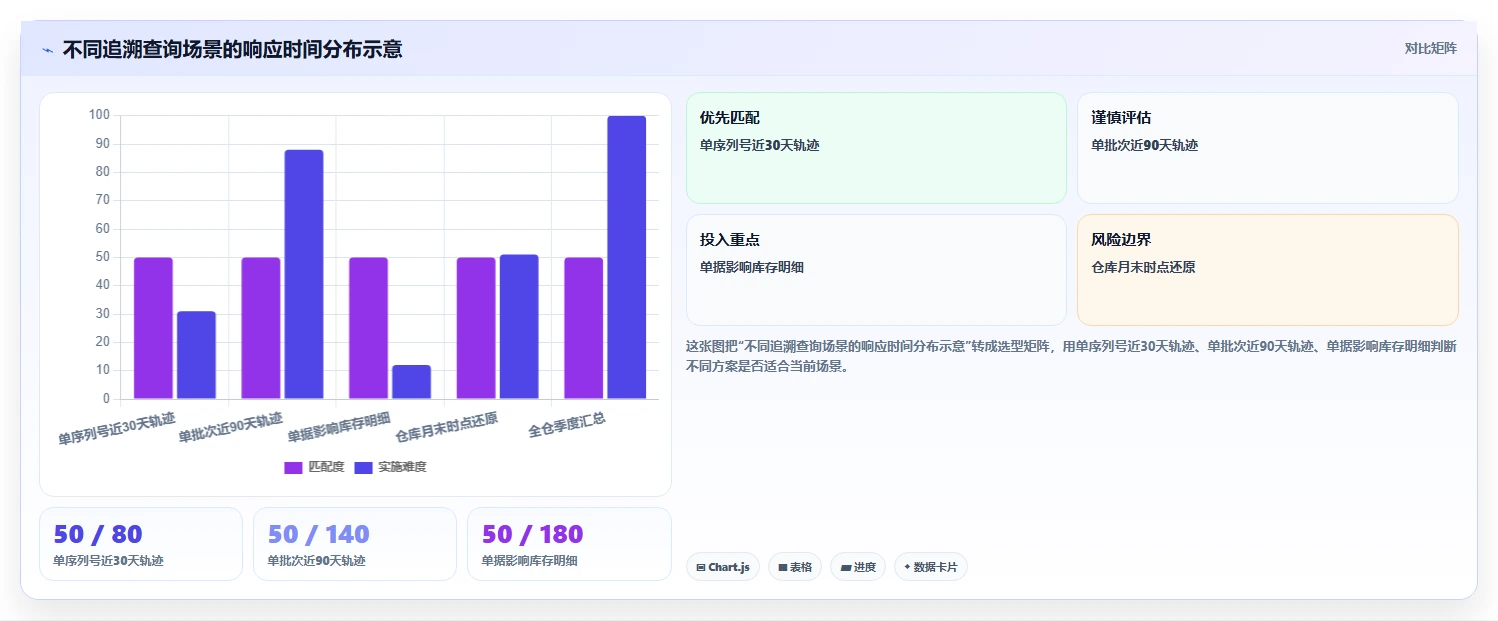
性能压测只能说明查询快不快,不能说明结果对不对。历史追溯还需要做回放测试:给定一组期初库存和事件,系统是否能得到预期状态;加入冲正、重复和乱序后,结果是否仍然符合规则。
回放测试最好覆盖正常流程和异常流程,并保存输入事件、预期结果、实际结果和差异原因。它可以作为数据迁移、版本升级和归档恢复的回归测试。
立项时最有价值的产物,不是数据库选型表,而是一张从业务动作到库存结果的追溯链路图。图中至少要标明订单、单据、作业、设备、库存事件、余额和报表之间的关系。
同时列出未来两年最可能出现的追溯维度。这里不要求预测所有需求,只需要识别那些一旦缺失就无法从历史补回的事实,例如批次、序列号、货主、库位和质量状态。
团队应把数据分成三类:必须保留的原始事实、可以由事实计算的当前结果、可以按需生成的分析指标。
原始事件一旦生效,原则上不直接覆盖;当前余额允许被重算或修复,但要记录修复依据;报表指标不一定进入交易库,只要可以从可信事实重新生成即可。
这一步能避免把“展示需要”误当成“事实存储”。例如,页面上的“最近一次操作描述”可以计算或缓存,但不能因为需要展示它,就把所有历史操作压缩成一个字段。
历史追溯最怕旁路写入。正常入库走一套服务,人工调整走另一套脚本,设备回传又直接更新数据库,最后事件表只记录了部分变化。
建议统一库存变化入口,至少让以下动作经过同一套事件生成和一致性控制:入库、出库、调拨、盘点、冻结、解冻、状态转换、退货和人工调整。
如果确实需要批量修复,也要让修复操作产生明确的补偿事件,并保留审批和执行记录,而不是直接在余额表执行无说明的 SQL。
上线验收应加入真实追溯问题,例如“找出某批次从收货到出库的所有节点”“还原昨天 18 点某库位库存”“说明某次盘点差异由哪些事件造成”。
如果系统只能导出几张表,让业务人员自行拼接,说明产品界面和数据模型都还没有真正完成追溯能力。
历史表增长后,索引和查询性能会变化;业务流程调整后,事件类型和字段质量也会变化。运行阶段需要监控事件缺失率、重复率、无法关联单据的比例、余额核对差异率和追溯查询 P95。
这些指标比单纯监控数据库 CPU 更接近业务风险。CPU 正常并不代表历史链路完整,数据库没有报错也不代表库存可以被解释。
这是最适合多数中小仓储系统的起点。余额表负责当前库存,变更流水保存数量变化、来源单据、时间、操作人和幂等信息。
它的优点是实现成本相对可控,业务人员容易理解,能够覆盖基础盘点、对账和批次追溯。缺点是复杂状态变化、时间点回放和跨对象关系需要额外设计。
适用场景包括商品种类较少、历史保留周期明确、单件追踪要求不高、查询模式比较稳定的仓库。
这种方案把事件作为主要事实来源,当前余额作为投影结果。每次库存变化先形成事件,再更新或重建当前状态。
它的优点是历史完整、可回放、扩展新事件类型相对容易。缺点是事件顺序、幂等、补偿、重放和一致性处理更加复杂,对团队工程能力要求更高。
适用场景包括多种库存状态、复杂调拨、强追溯要求、设备和多个外部系统接入,以及未来需要频繁重建读模型的系统。
这种方案将在线交易和复杂历史分析分开。交易库保存实时业务所需数据,事件或变更数据同步到历史库、数据仓库或分析平台。
优点是能降低复杂报表对交易库的影响,也便于长期保存和跨周期分析。缺点是存在同步延迟、数据链路更多、权限和一致性治理更复杂。
适合数据量大、历史分析需求多、实时交易和报表查询并发明显冲突的场景。若团队没有数据运维能力,不建议一开始就搭建过多中间层。
数据库审计、CDC 或应用操作日志可以作为辅助证据,但不宜直接当成完整业务追溯模型。它们适合补充谁修改了什么、捕获数据变化或同步下游系统,却未必包含业务单据、仓库对象和库存语义。
如果业务只需要管理员修改留痕,审计日志可能足够;如果需要解释库存数量变化和批次流向,就必须建立业务事件层。
| 方案 | 初始建设成本 | 历史回放能力 | 长期扩展性 | 主要风险 | 适用边界 |
|---|---|---|---|---|---|
| 余额表加变更流水 | 较低 | 中等 | 中等 | 复杂状态和跨对象关系需补充设计 | 中小规模、需求相对稳定 |
| 事件事实加状态投影 | 中高 | 较强 | 较强 | 幂等、乱序和重放复杂 | 复杂仓储、强追溯、多系统接入 |
| 交易库加历史分析库 | 中高 | 强 | 较强 | 同步延迟和治理链路增加 | 大数据量、分析需求多 |
| 仅依赖数据库审计 | 较低 | 较弱 | 较弱 | 缺少业务语义和单据关联 | 仅需技术操作留痕的场景 |
很多技术选型只比较开发周期和服务器成本,却忽略了历史缺失后的失败成本。对于普通商品仓,少保留一些低频字段可能是理性取舍;对于质量召回、药品批次或高价值设备,历史链路缺失可能造成客诉、召回范围扩大和责任无法认定。
我建议将方案评估拆成四个维度:业务损失、合规要求、数据规模和团队能力。只有当复杂架构能够降低明确的业务风险时,才值得承担它的建设和运维成本。
旧系统迁移到新系统时,团队通常先统计表行数、字段映射和导入耗时,却很少先判断历史数据是否具备足够的业务语义。
如果旧系统只有当前余额,没有完整流水,就不能把迁移后的结果描述为“完整历史追溯”。更准确的做法是区分:可验证的历史事实、从单据推导的历史记录、无法确认来源的期初数据。
这种区分很重要。把推导数据伪装成原始事实,可能让新系统在审计时产生更大风险。
新系统往往需要导入某个时点的期初库存。期初库存不一定有完整事件链,因此应保存期初批次、来源系统、盘点时间、导入批次、确认人和校验结果。
后续事件从这个期初点开始累计,查询页面也应明确显示“历史起点”。这样业务知道哪些数据可以回放,哪些数据只能作为迁移时的初始快照。
迁移发现批次为空、单位不一致或数量对不上时,最忌讳直接把数据改成“看起来合理”的结果。所有修订都应有问题清单、处理规则、责任人和前后对比。
如果必须合并多个旧批次或拆分库存,也要保留转换关系。否则新系统虽然导入成功,却无法说明新批次与旧数据的对应关系。
数量相等只是迁移验收的最低标准。如果数量相等但来源、时间和状态缺失,系统仍然不具备完整追溯能力。
仓储业务会变化,组织会变化,客户会变化,设备接入方式也会变化。所谓一次设计、永久不改,通常只是宣传语。真正成熟的模型,不是让团队永远不改表,而是让变化集中在明确的扩展层、事件类型和读模型中。
如果新增一种业务动作就必须重写所有历史记录,说明事实层设计不够稳定;如果新增一个低频展示属性就必须改动交易核心表,说明扩展边界没有划清;如果每次修正都直接覆盖原数据,说明审计和补偿机制还没有建立。
设计预算有限时,不要平均地保存所有字段。应优先保留那些未来无法从其他数据推导出来的信息:业务发生时间、库存对象、批次或序列号、库位、货主、来源单据、实际变更量和操作主体。
而页面展示字段、报表派生指标和部分低频属性,可以根据查询需求后续生成或进入读模型。这个取舍比“所有字段都保存”更可控,也比“只保存最终余额”更安全。
如果系统只能告诉业务“某人修改过数量”,却不能告诉业务这次变化对应什么单据、哪个批次、哪个库位、何时发生以及是否被冲正,它提供的是操作痕迹,不是历史追溯。
如果系统有很多流水,但当前余额无法和流水核对,提供的是数据堆积,不是可信事实。历史追溯的判断标准始终应该是:面对一个具体业务问题,系统能否用可验证的数据给出完整答案。
如果团队正在新建仓储系统,建议在进入详细表设计前,先完成一轮历史追溯工作坊。让产品、仓库负责人、后端、数据库和数据分析人员共同列出至少十个真实追溯问题,并标注每个问题需要的对象、时间、来源和权限。
如果系统已经上线,先不要急着重构全部数据库。可以从一个高价值场景开始,例如批次召回、盘点差异或人工调整审计,建立统一事件编号、来源单据关联和余额核对机制,再逐步覆盖其他库存变化入口。
如果系统已经出现历史数据缺失,应先做数据可信度分级:哪些是原始事实,哪些是单据推导,哪些只是期初快照,哪些无法确认。明确边界后,再决定是否迁移、补偿、归档或重新采集。
仓储数据库真正的长期债务,不是表字段少,而是系统无法说明库存为什么变成现在这样。先把事实、状态、单据和审计分开,再围绕真实查询设计索引、快照和历史库;先保证关键链路可解释,再讨论分库分表和复杂架构。这样做,系统才不是只在今天能查库存,而是在未来面对新批次、新货主、新设备和新合规要求时,仍然能够稳定扩展。
我们现在的库存表里已经有入库时间、最后操作人和最后修改时间,业务觉得这样就能追溯了。但我担心每次出库或调拨都会覆盖旧值,后面如果要查某个时间点的库存,数据库还能不能还原当时的真实状态?
不能。库存表通常保存的是“当前结果”,而历史追溯要解释的是“这个结果是怎样形成的”。例如,当前库存表显示某批物料还剩 120 件,但它无法单独说明这 120 件分别来自哪几次入库、经历过几次调拨、是否被盘点调整过,也无法证明某次人工修改是否合理。
我在做数据模型评审时,会把数据拆成四层:当前库存状态、业务单据、库存变化事件和审计记录。当前状态负责高频读取,业务单据负责表达入库、出库、调拨等业务意图,事件记录负责保存数量和位置的变化,审计记录则回答“谁在什么时间修改了什么”。这四层可以关联,但不应混成一张表。
数据类型主要回答的问题是否允许覆盖 当前库存现在有多少可用库存可以更新 业务单据业务上要做什么通常保留状态变更 库存事件库存为什么发生变化原则上追加记录 审计记录谁改了什么数据原则上不可覆盖 更稳妥的做法是让库存事件至少包含物料、批次或序列号、仓库、库位、数量变化、业务事件类型、来源单据号、业务发生时间、操作主体和幂等号。
当前库存可以由事件计算或核对,但不建议每次查询都实时扫描全部历史事件。一个实用判断标准是:如果删除当前库存表,只保留历史事件,团队能否在合理时间内重建某个时间点的库存?如果答案是否定的,说明系统保存的可能只是操作日志,而不是足以解释库存状态的业务事实。
我看到团队经常把“操作日志”“库存流水”和“事件表”当成同一个东西,最后表里只有操作时间和操作人。实际遇到盘点差异或接口重试时,我不知道应该查哪张表,也不确定这些记录能不能作为完整的业务依据。
这三个概念最大的区别,不在于表名,而在于它们回答的问题不同。业务流水描述一次业务动作,事件记录描述状态发生了什么变化,审计日志描述系统中的谁以什么方式修改了数据。三者如果没有清晰分工,系统很容易出现“日志很多,但事情解释不清”的情况。例如一次出库可以产生一张出库单、一条库存扣减事件和多条审计记录。
出库单说明业务申请和审批过程;库存事件说明 A 批次在某库位减少 10 件、被哪个单据触发;审计记录则说明哪个账号修改了出库单状态,修改前后分别是什么值。
记录典型字段适合查询不能替代什么 业务流水单据号、业务类型、状态、审批信息业务流程和单据进度不能替代库存变化明细 库存事件对象、数量、前后状态、来源单据库存变化和流转链路不能完整替代权限审计 审计日志账号、时间、接口、字段前后值责任追踪和异常操作不能自动证明业务合法性 我会特别检查“事件是否能脱离日志独立解释”。
如果一条记录只有 event_type、operator 和 update_time,却没有业务对象、数量变化、来源单据和前后状态,那么它更像技术操作日志,而不是可回放的库存事件。另外,时间字段也不能只保留一个 timestamp。至少要区分业务发生时间、请求到达时间和数据库落库时间。
接口延迟、消息重试或跨系统传输时,这三个时间可能相差几分钟甚至更久;如果混用,按时间回放库存时就可能得到错误顺序。
我们一期只追踪商品和批次,后来业务又要求查询序列号、库位轨迹和货主维度,团队每增加一种条件就要改表、补索引,旧数据还经常无法关联。到底应该提前把所有字段都设计好,还是把扩展属性全部放进 JSON?
两种做法都容易走极端。把所有可能字段提前塞进宽表,会造成字段语义不稳定、索引数量失控;把所有字段放入 JSON,又会牺牲约束、查询性能和数据质量。我的判断原则是:高频过滤、强一致、需要关联的字段结构化;低频、变化快、展示性质较强的附加属性才考虑扩展字段。
批次、序列号和库位也不应被强行当成同一种追踪对象。批次更关注一批货物的来源和去向,序列号关注单件设备的生命周期,库位关注位置变化轨迹,货主则影响数据隔离和库存归属。它们可以共享事件主表,但明细粒度和索引策略应有所区别。
追溯维度建议粒度典型查询设计关注点 批次批量事件某批次去了哪些订单来源、去向、数量平衡 序列号单件事件某设备经过哪些库位唯一性、顺序和生命周期 库位位置变更事件某库位何时发生库存变化库位层级和时间范围索引 货主隔离维度某货主当前及历史库存权限、分区和数据边界 在一次模型评审中,我通常会要求团队现场回答三个问题:新增序列号追踪是否需要迁移全部历史数据;
新增一个库存状态是否要修改所有历史记录;按批次查询近一年事件时,是否会扫描无关货主和仓库的数据。如果每个答案都要大范围改表或补数据,说明模型的扩展成本已经偏高。可以采用“稳定核心字段加扩展属性”的组合方式。物料、批次、序列号、仓库、库位、货主、事件类型、数量、业务时间和来源单据应保持结构化;
质检附加信息、设备上报参数等低频字段可以放在扩展列,但不能把核心追溯链路隐藏在 JSON 里。
我们把历史流水和当前库存放在同一个数据库,平时数据量不大时没有问题。可一旦按批次查询半年记录,页面就会变慢,甚至影响出库写入;我想知道什么时候该分区、归档、读写分离,什么时候只是索引没有建对。
先不要把“查询变慢”直接归因于数据库规模,也不要一上来就分库分表。仓储历史查询通常有三个风险:时间范围过大、关联链路过长、查询条件与索引顺序不匹配。只有先确认慢查询的扫描行数、锁等待、返回数据量和执行计划,才能判断是索引问题、模型问题还是资源隔离问题。我会用一组固定场景做压测,而不是只测单条查询。
测试数据至少覆盖近 12 个月的库存事件,并分别验证按批次、按序列号、按单据、按库位和按时间范围查询;同时保持入库、出库和盘点写入压力,观察历史查询是否影响在线交易。
验证项目需要记录的指标异常信号 历史查询P95/P99 延迟、扫描行数、返回行数扫描量远大于结果量 在线写入写入延迟、锁等待、失败率查询高峰时写入抖动 索引效果执行计划、命中率、索引大小索引存在但未被使用 归档影响归档耗时、主库空间、归档后查询时延归档任务阻塞交易 如果主要问题是时间范围扫描,可以优先考虑按业务发生时间做分区,并结合货主、仓库或事件对象设计查询索引;
如果历史查询与在线交易争抢资源,可以增加只读副本或独立查询模型;如果数据已经超过在线库适合承载的规模,则应建立归档库或分析库,而不是继续堆索引。归档策略必须在上线前确定。
需要明确在线数据保留多久、归档后是否仍要按批次查询、历史记录能否恢复、归档任务是否可重入,以及归档库中的数据是否与主库保持可验证的数量平衡。很多团队只设计了“把旧数据搬走”,却没有设计“搬走后如何证明没有丢数据”。
最终的选型顺序应是:先保证事件模型和查询条件正确,再优化索引和分区,最后根据压测结果决定是否做读写分离、归档或独立查询服务。没有压测数据支撑的架构升级,往往只是把问题从慢查询变成更高的运维复杂度。



读者评论
文章把当前库存、业务单据、变更事件和审计记录的职责区分得比较清楚,尤其是用冲正替代直接修改历史这一点,对需要审计的仓储场景很实用。
时间语义和幂等标识是很多系统容易忽略的细节。文章没有只谈表结构,还考虑了异步、补录和重复消费,比较贴近实际项目中的问题。
方案思路完整,但事件表、归档和读模型会增加开发及运维成本。落地时还需要结合查询频率、数据量和审计要求分阶段实施,不能一开始就过度设计。