

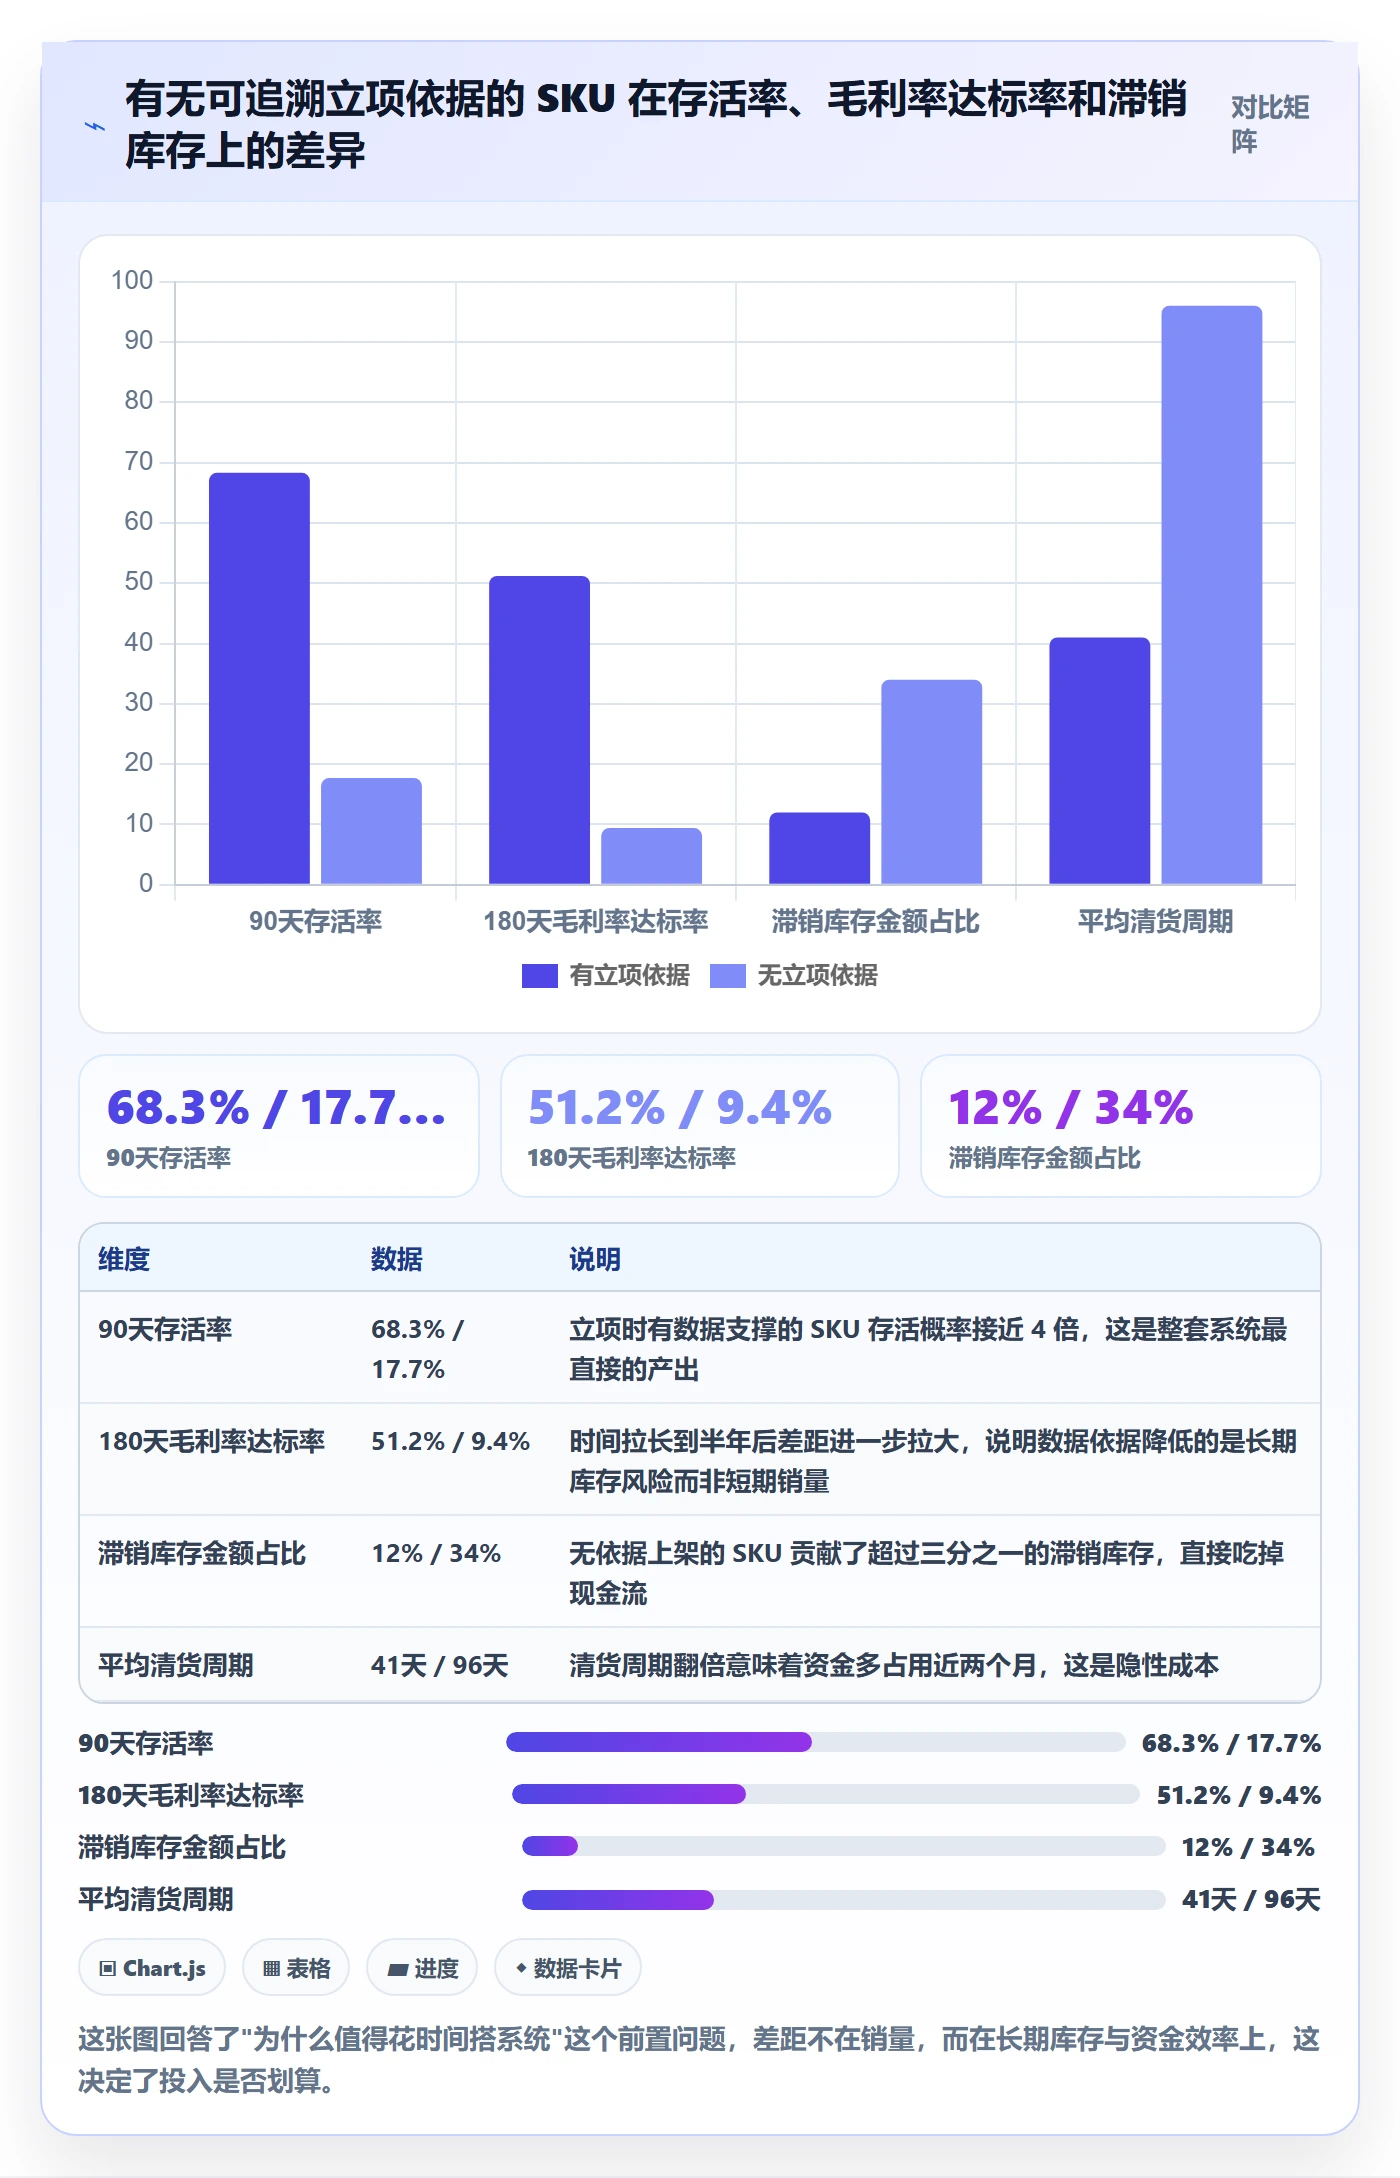
2024 年 3 月,我做了一件让自己很不舒服的事:把过去 14 个月上架的 137 个 SKU 全部拉出来,逐个回填"立项依据"。结果相当难看,其中 96 个 SKU 的立项依据只有一句话:"感觉这个能做。"而那 96 个"凭感觉"上架的产品里,真正活过 90 天、并且毛利率站上 18% 的,只有 17 个,占比 17.7%。剩下 41 个有数据依据的 SKU,同期活下来 28 个,占比 68.3%。
这组数字直接推翻了我原来的一个假设:我一直以为自己的问题在于"数据源不够好"。但真实情况是,我的问题在于从来没有把选品工具当成一套可验证的系统来使用,只把它当成了一个搜索框。同一批工具,在两个不同使用方式下,产出差了将近 4 倍。
这篇文章是我 2024 年 4 月到 7 月、历时 90 天的完整复盘。涉及 3 个店铺、2 个一级类目(家居收纳、户外轻装备),数据来自我自己的内部台账,金额按人民币口径换算,已做脱敏。我会把三轮筛选的真实转化数据、一次彻底的失败案例、以及"什么时候该加码、什么时候该停手"的判断逻辑全部摊开讲。
我把 90 天验证期跑完之后,最想告诉别人的一句话是:选品工具最值钱的能力,是稳定地说"不"。一个能每天给你推 20 个"潜力爆款"的工具,和一个能每天帮你干净利落地否掉 200 个不该碰的产品的工具,后者对生意的价值可能高 10 倍。
我在这次复盘里定下了三个"系统有效性"的判定指标,它们不直接等于利润,但能提前 60 到 90 天预测利润。第一个是无效候选品淘汰率:进入初筛的产品里,有多大比例被明确否掉并留下了理由。第二个是决策周期:从一个想法进入候选池,到做出"立项 / 放弃"的最终决定,平均花了多少天。第三个是立项后 90 天达标率:立项上架的产品里,有多少达到"月销 ≥ 60 单且毛利率 ≥ 18%"的及格线。
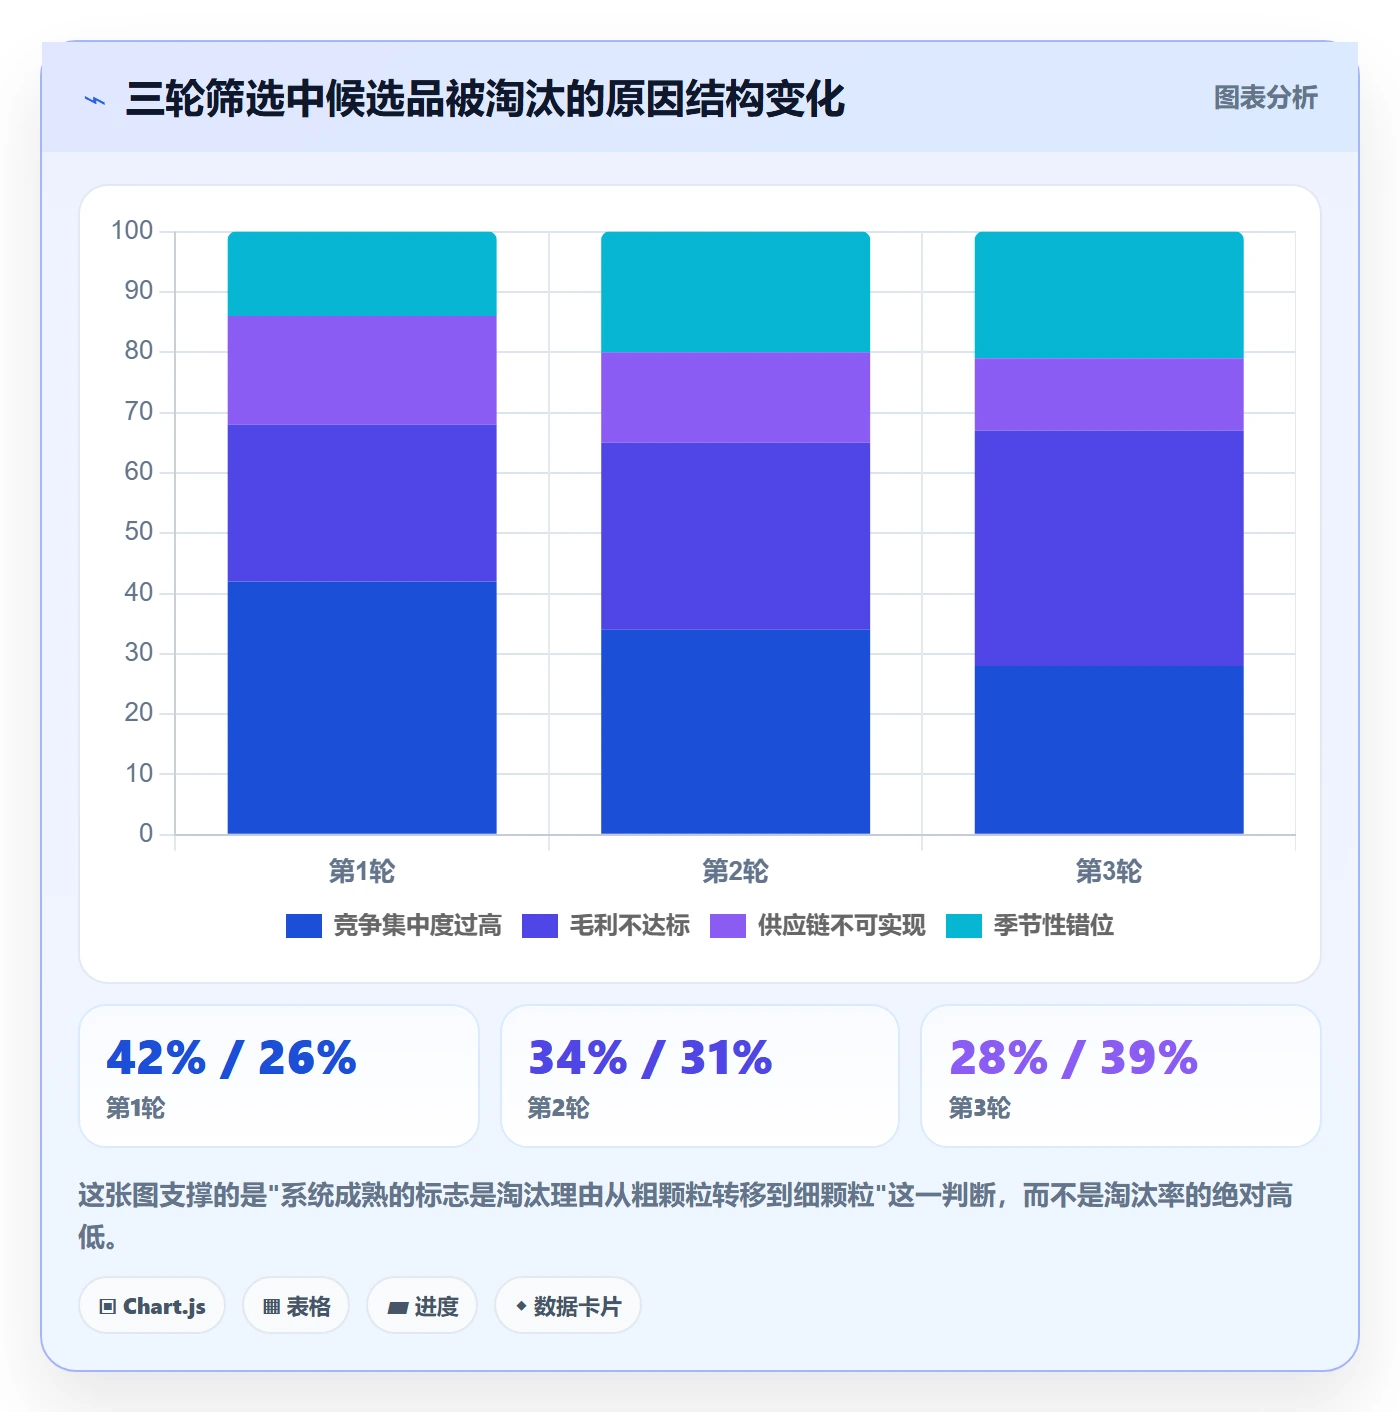
这三个指标组合起来看,会暴露一个很反直觉的现象:淘汰率低不一定代表机会多,往往代表标准松。我第一轮筛选的淘汰率只有 86.5%,第三轮升到 88.8%,看起来变化不大,但第三轮立项产品的 90 天达标率是第一轮的 1.22 倍。原因不在淘汰率本身,而在淘汰的"理由结构"变了。
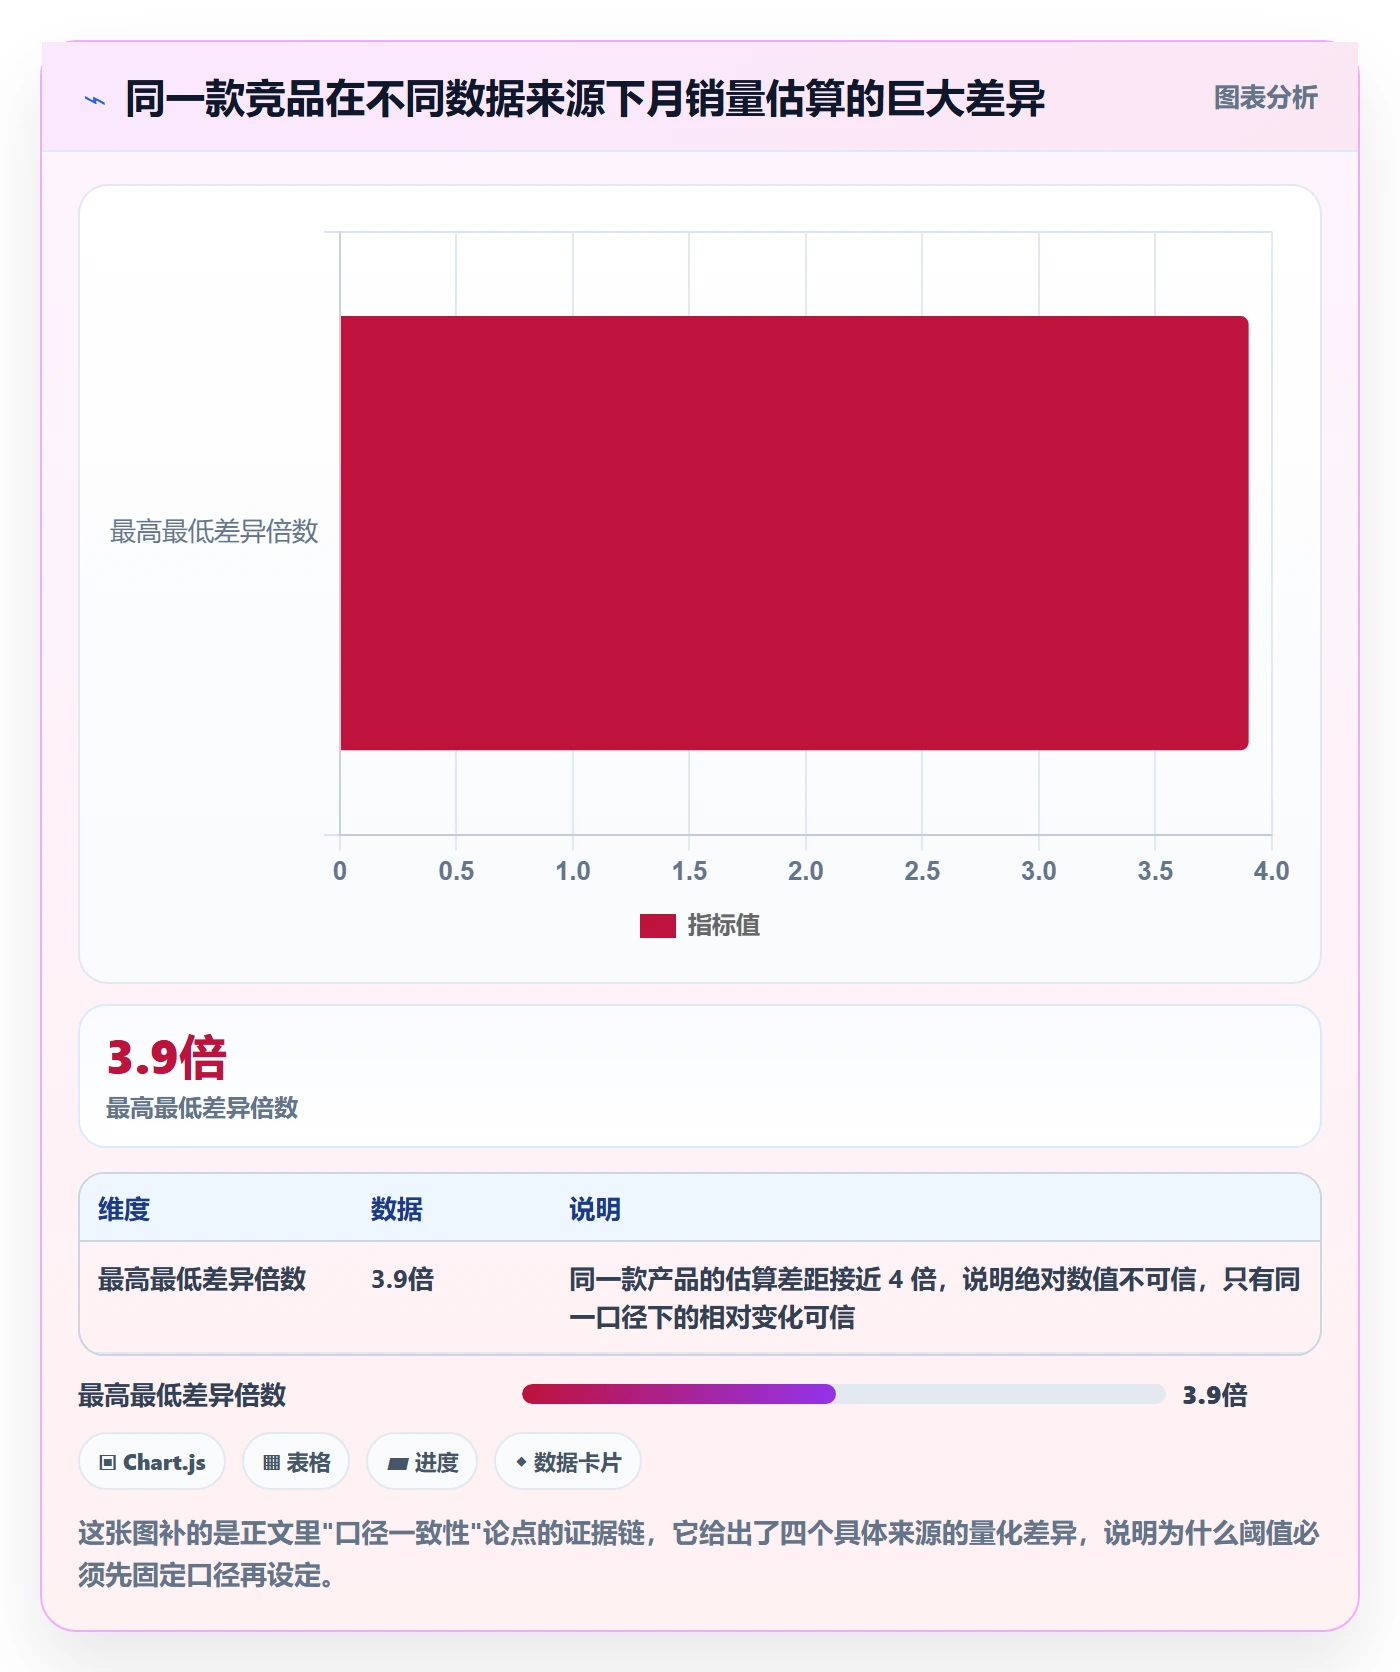
第一条:工具的准确率不是关键变量,口径一致性才是。我做过一次交叉测试,同一款竞品,四个不同来源给出的月销量估算分别是 1,850 件、620 件、1,240 件和 2,400 件,最高最低差了 3.9 倍。如果今天用 A 口径、明天用 B 口径,你的阈值就永远无法校准。
第二条:现金流比毛利率更早报警。我在第一轮筛选中放过了两个"毛利率 32% 但体积重、海运周期 52 天"的产品,结果它们的资金周转天数是其他产品的 2.4 倍,第四个月就把现金流拖到了警戒线。选品系统必须把"资金占用天数"当成一级指标,而不是二级指标。
第三条:失败的产品比成功的产品信息量更大。我在这 90 天里记录了 380 条淘汰理由,最后发现真正能复用的规律,全部来自这些被淘汰的产品。成功案例往往有运气成分,淘汰理由却是可重复的因果链。
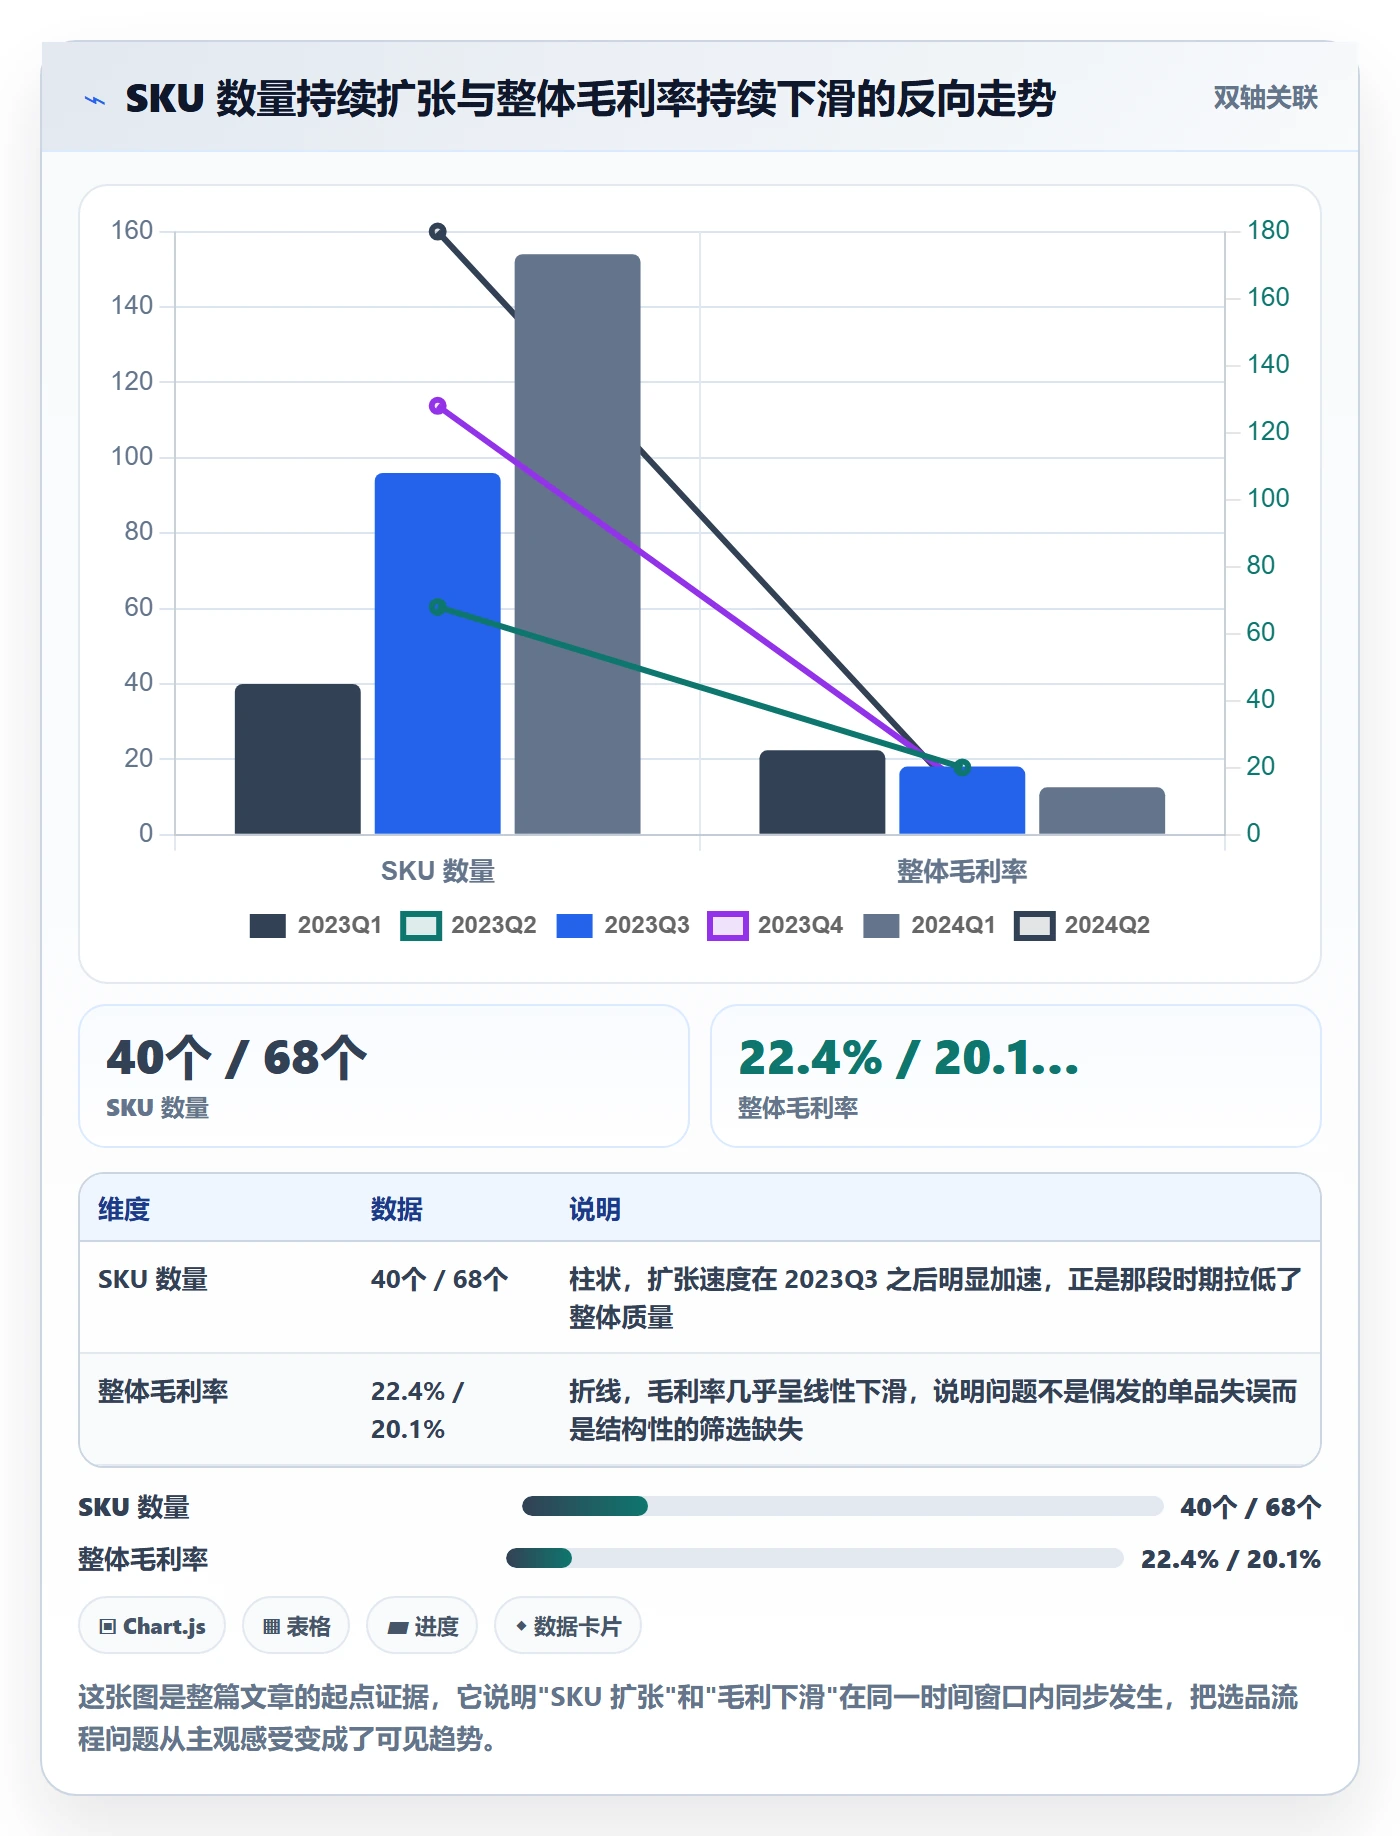
先把时间线拉回去。2023 年第一季度,我们团队 3 个人,主营店铺在售 SKU 40 个出头,整体毛利率 22.4%。那时候我的选品方式非常原始:逛榜单、看竞品、感觉差不多就下单 300 件试水。因为盘子小,错了也亏不了多少。
真正的转折点在 2023 年第三季度。那半年我们为了冲销售额,把 SKU 数量从 40 个一路加到 154 个,选品节奏快到什么程度?平均每 2.3 天就要决定一个新 SKU 上不上。到 2024 年第一季度,在售 SKU 达到 180 个,整体毛利率掉到了 11.2%。
更麻烦的是库存。仓库里躺着 40 多个"上架三个月、累计出单不到 30 件"的产品,占用的采购资金接近 27 万元。那段时间我最大的感受不是"没找到爆款",而是"我根本不知道自己为什么选错了"。因为每次决策都是拍脑袋,事后没有任何可以追溯的依据。
2024 年 4 月 1 日,我给自己定了一个 90 天的硬期限,把它拆成三段,每段 30 天,每段跑一轮完整的"扫描,筛选,测试,回流"循环。三轮不是重复,而是刻意设计成渐进式收紧:第一轮宽进严出,先把口径跑通;第二轮验证阈值是否合理;第三轮检验系统能否稳定复现。
每一轮的节奏是这样的:第 1 到第 10 天做类目扫描和候选池生成,第 11 到第 18 天做数据初筛和深度评估,第 19 到第 24 天做立项决策,第 25 到第 30 天做小预算广告测款并回填结果。关键约束是:每一轮的决策必须在 30 天内闭环,不允许"再看看"。
这条约束听起来很硬,但它解决了一个真实存在的顽疾,以前我们的决策平均要拖 26 天,很多候选品在"再看"的过程中错过了最佳上架窗口,最后不了了之,连失败的原因都留不下来。
这个分工最重要的设计是把"找数据"和"下判断"拆开。我发现只要同一个人既找证据又做结论,他的结论一定会偏离阈值,因为他会不自觉地收集支持自己想法的数据。这是我在第二轮里纠正的最大组织问题。
在讲具体怎么搭之前,我必须先把坑说清楚。这五个误区我全部亲身踩过,其中第三个让我在 2023 年直接亏掉了一个季度的利润。
绝大多数人选品工具的使用方式是:输入类目,按销量排序,看前 20 个,挑一个顺眼的。这个用法的问题在于,你把工具的排序算法当成了商业判断。但工具能看到的只是公开的销量估算、评论数和排名波动,它看不到你的供应链成本、你的广告效率、你的资金周转能力。
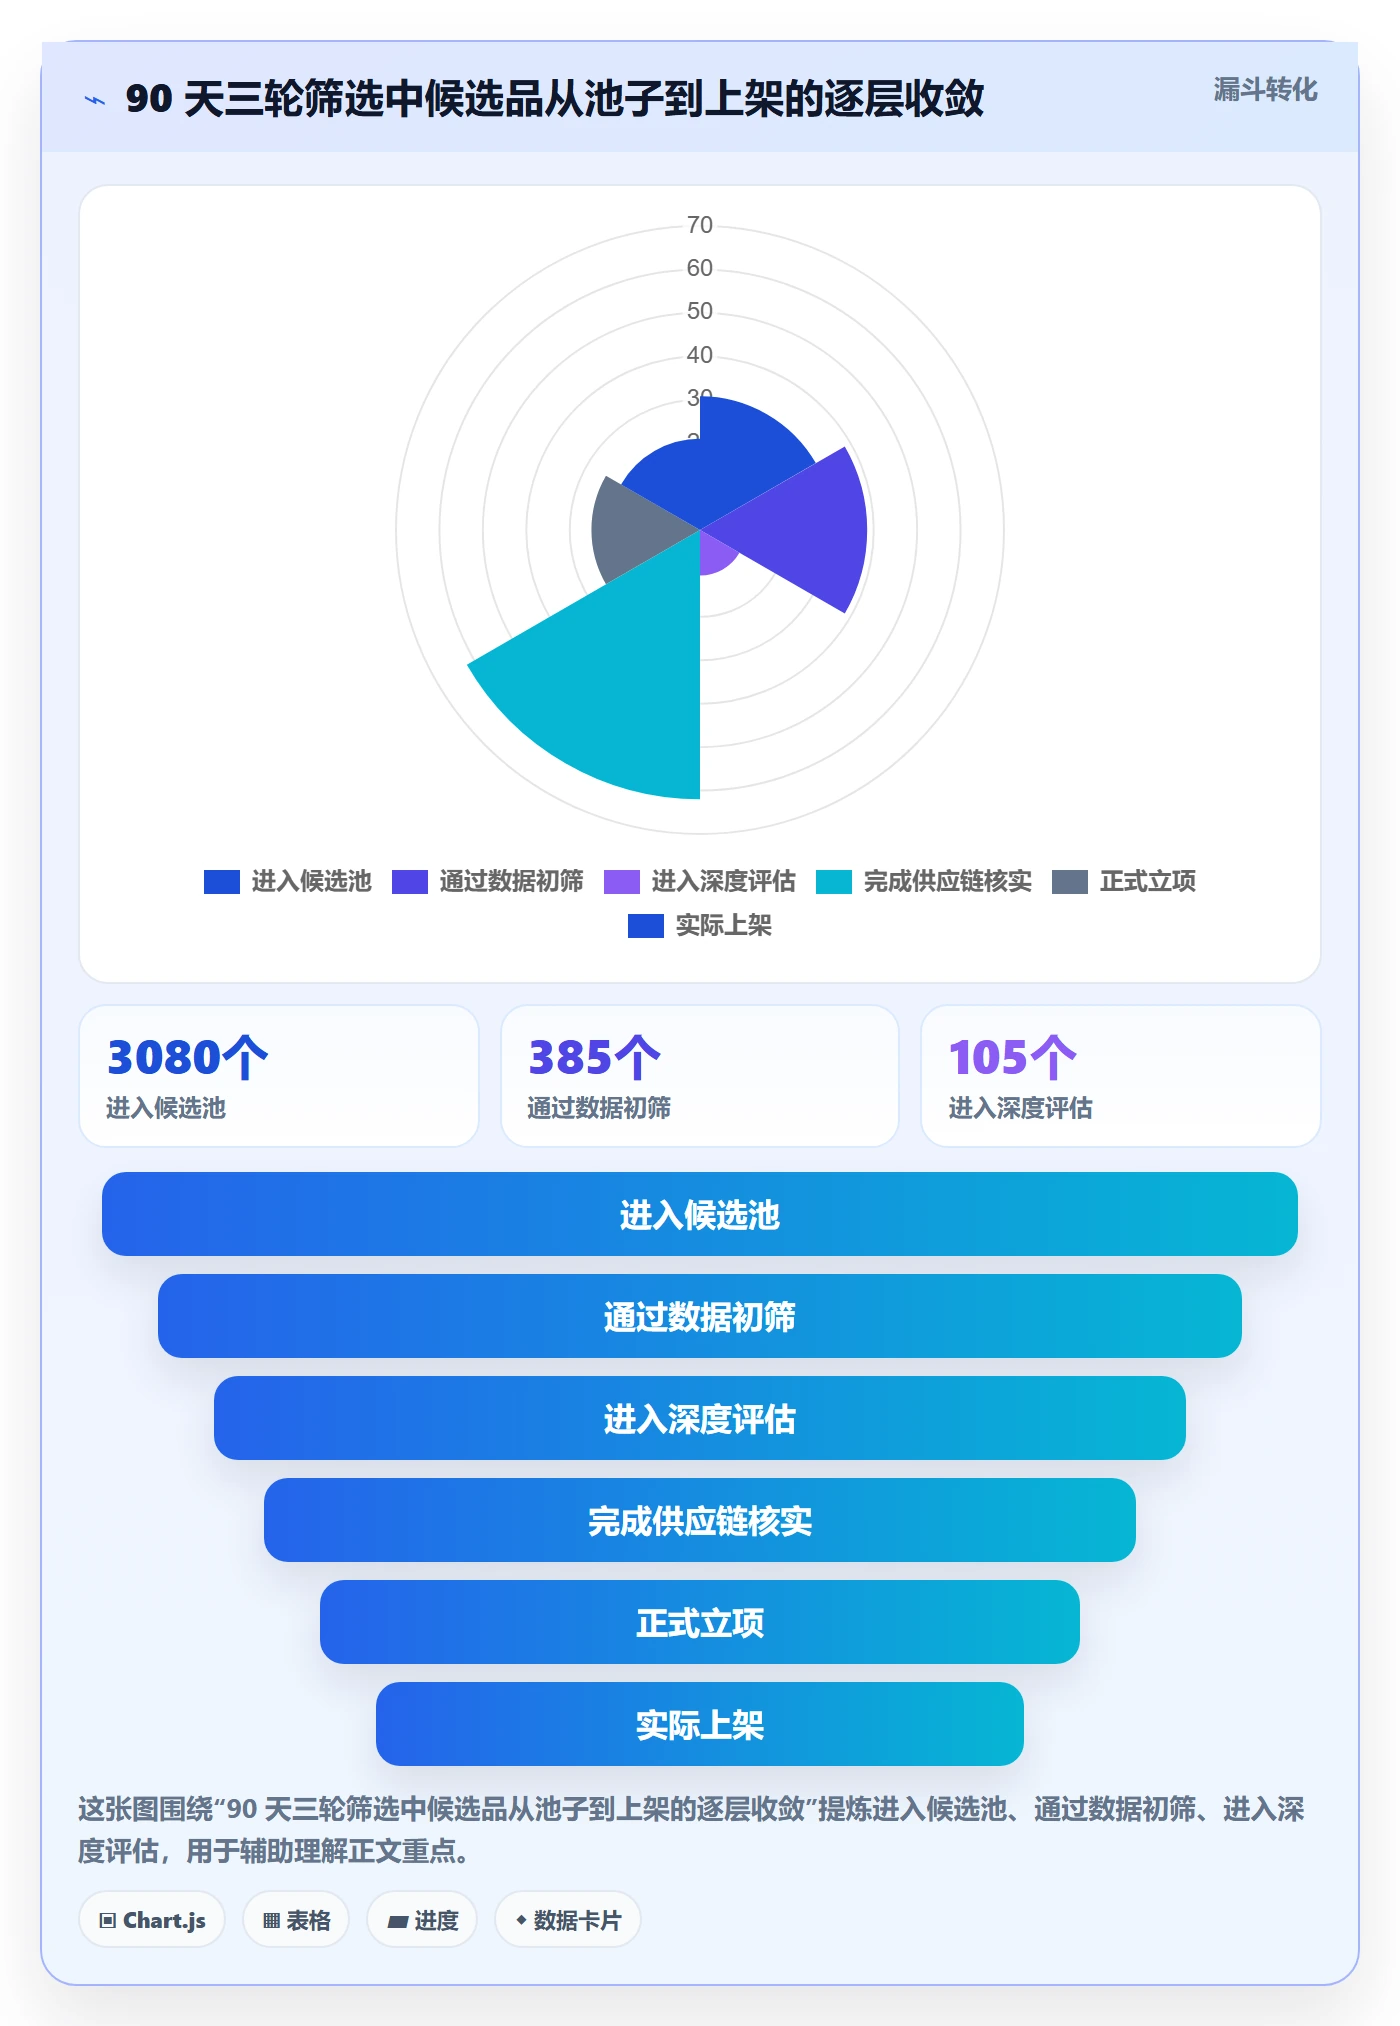
正确的定位是:工具负责把 3,000 个候选压缩到 300 个,你负责把 300 个压缩到 30 个,供应链负责把 30 个压缩到 10 个。每一层都用不同的判断维度,工具只承担第一层。
2023 年我做过一个决策,某关键词月搜索量 8.7 万,我看了一眼就拍板了。上架之后 45 天只出了 22 单。后来拆解才发现,这个 8.7 万的搜索量里,头部三个词根贡献了 61%,而且全部指向一个已经形成品牌心智的价格带,我的定价卡在中间,既没有性价比优势也没有品牌溢价。
搜索量是"总需求",但真正决定你能不能吃到的是"可争夺需求"。可争夺需求 = 总搜索量 × 非品牌词占比 × 你的价格带匹配度。这三个因子任何一个接近零,前面的数字再大也没用。
我经历过最惨的一次是只看 BSR。2023 年第二季度,我选了一款 BSR 稳定在 800 名左右的产品,看起来需求量很稳。但实际结果是:这个排名是靠高频秒杀和站内广告硬撑起来的,我上架后没有对应的广告预算,自然流量占比从预期的 62% 掉到了 21%,广告成本直接吃掉全部毛利。
单一指标最危险的地方在于,它看起来很客观。BSR、月销量估价、搜索量、评论数,任何一个单独拿出来都能构成一个"看起来有理有据"的决策,但它们都不构成决策依据,只构成决策约束。
这是最容易被忽视、也最致命的一条。同一款产品,我用 30 天窗口和 90 天窗口分别统计数据,需求稳定性评分差了 34 分。30 天窗口受促销季影响严重,会把短期爆发误判为长期需求。
我的做法是强制使用双窗口:所有需求类指标必须同时给出 30 天和 180 天两个口径,两者偏离超过 40% 的候选品,一律标记为"季节性待确认",进入人工复核而不是直接淘汰。
这是最普遍、也最贵的一个误区。2023 年我在工具订阅上花了大概 1.8 万元,但真正的决策质量几乎没变。因为工具提供的是数据,系统提供的是数据到决策之间的转换规则。规则不写下来,工具就只是个更贵的搜索框。
判断标准很简单:如果你今天停掉所有工具订阅,你的选品流程能不能继续运转?如果答案是"不能",说明你依赖的是工具而不是系统。我 90 天验证期结束后,即使停掉其中一个平台,流程依然能跑完,只是效率下降约 30%,这才是健康状态。
讲完误区,回到正题。我把这套系统的核心逻辑总结成一句话:先定义决策单位,再定义指标,最后写死阈值。顺序不能乱,因为大部分人是从指标开始的,结果就是指标越加越多,决策却越来越慢。
很多人把决策单位定义成"一个产品"。这是错的。因为你决定上架一个产品时,真正承担风险的是"产品 + 首批采购量 + 验证周期 + 广告预算"这个组合。同一个产品,首批 300 件和首批 1,500 件的风险完全不同。
我把决策单位重新定义为:产品 × 首批采购量 × 验证周期(21 天)× 测款广告预算(1,500 到 3,000 元)。定义完之后,很多看起来"还不错"的产品会自动出局,因为它们在 21 天、3,000 元的约束下根本跑不出有效信号。
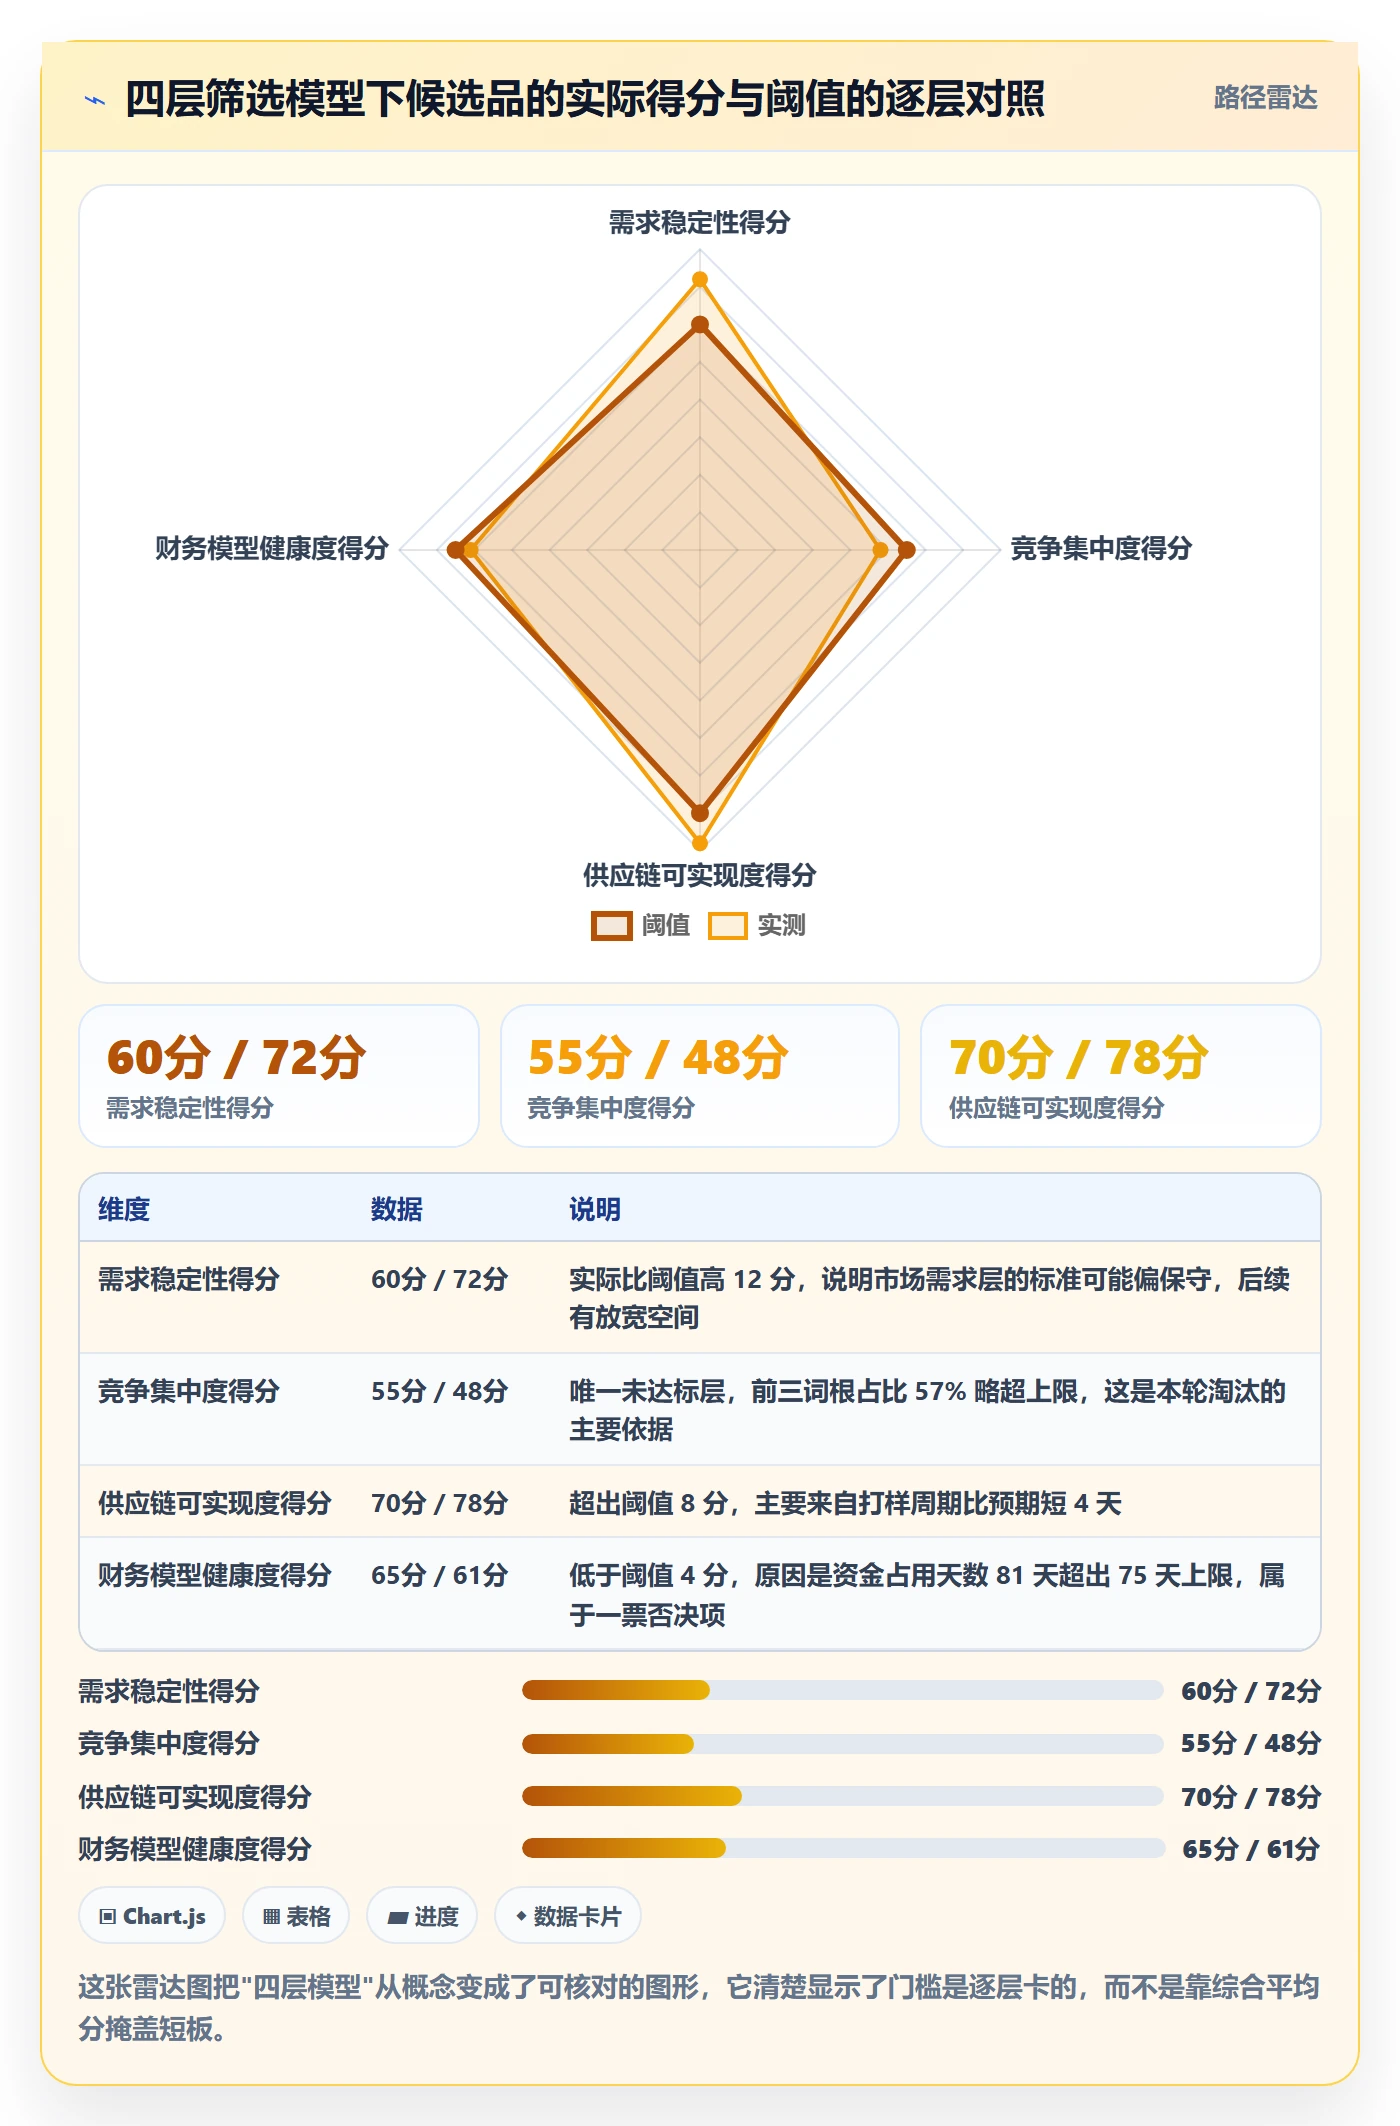
我的筛选模型分四层,每层 2 到 4 个指标,每层有独立的及格线,四层必须全部通过才进入立项,任何一层不通过就直接淘汰,不做综合打分妥协。这四层分别是:市场需求层、竞争结构层、供应链可实现层、财务模型层。
"阈值先行"的含义是:在跑数据之前,把阈值写死在配置文件里,跑完数据只看是否越线,不允许事后调整。我第一轮就吃过亏,数据出来后觉得某个产品"就差一点点",手动放宽了标准,结果它成了那一轮唯一一个 90 天未达标的产品。
# selection_rules.yaml , 阈值先行的配置文件示例
说明:所有阈值在跑数据前写死,本文件纳入版本管理,改阈值需记录 commit 理由

model_version: v3.2

effective_from: 2024-06-01

layer_1_demand:      # 市场需求层

search_volume_30d: {min: 8000}          # 月搜索量下限

search_volume_180d: {min: 20000}        # 半年搜索量下限

stability_score:   {min: 60}            # 需求稳定性评分(0-100)

window_deviation:  {max: 0.40}          # 30天与180天口径偏离上限

layer_2_competition: # 竞争结构层

top3_keyword_share: {max: 0.55}         # 前三词根搜索占比上限

brand_share:        {max: 0.35}         # 品牌词占比上限

review_median:      {max: 600}          # 竞品评论中位数上限

price_band_overlap: {min: 0.50}         # 我方定价带与主流成交带重合度

layer_3_supply:      # 供应链可实现层

moq:                {max: 500}          # 起订量上限

volume_weight_ratio:{max: 1.0}          # 体积重比,超过则头程成本失控

sampling_lead_days: {max: 18}           # 打样周期上限

historical_return:  {max: 0.06}         # 同类目历史退货率上限

layer_4_finance:     # 财务模型层

gross_margin:       {min: 0.28}         # 目标毛利率下限

cash_cycle_days:    {max: 75}           # 资金占用天数上限

break_even_units:   {max: 120}          # 广告投放下保本单量上限

payback_months:     {max: 3.0}          # 回本周期上限

一票否决项:任意一层任一指标越线,直接淘汰,不进入综合评分

veto: strict_by_layer这份配置看起来繁琐,但它的真正价值在于把"我为什么否掉它"变成一个可以复现的答案。第三轮筛选时,我能在 3 分钟内说清任何一个被淘汰产品的具体越线项,这是第一轮做不到的。
这是整套系统里我最推荐的一个动作。任何进入深度评估的候选品,在立项之前必须写下一句话:"如果发生 X,我就在 Y 天内放弃,不再追加投入。"这句话必须在花钱之前写,不能事后再补。
举个我第三轮的实际例子。候选品是一款户外折叠桌,我写的证伪条件是:"如果上架后 21 天内,自然订单占比低于 30%,或者广告 ACOS 连续 7 天超过 45%,立即停止追加广告预算,进入清货流程。"后来这两个条件在第二周同时触发,我在第 18 天就停手了,实际损失控制在 6,800 元。同款产品如果按 2023 年的做法,我大概率会追加到 2 万元以上才认输。
数据只能告诉你"这个地方有人在买",广告才能告诉你"你能不能比现有卖家更有效率地卖出去"。所以我的验证永远是双轨的:数据轨负责筛掉明显不该做的,广告轨负责确认剩下的到底能不能做。
小预算广告测试有几个硬约束:预算上限 3,000 元,时间窗口 21 天,只看两个指标,自然订单占比和广告边际 ACOS 的走势。前者判断产品能不能自己站起来,后者判断你的运营效率能不能随投入增加而改善。两者都不达标,说明这个产品的竞争结构已经僵化,不要硬撑。
# demand_filter.py , 需求结构与竞争集中度的计算片段(示意)
输入:关键词级数据(关键词、30天搜索量、180天搜索量、是否品牌词、所属词根)

输出:候选品是否通过第一层与第二层筛选

import pandas as pd

def calc_layer1(df: pd.DataFrame) -> dict:

"""市场需求层:双窗口口径 + 稳定性"""

v30, v180 = df["search_vol_30d"].sum(), df["search_vol_180d"].sum()

稳定性评分:30天均值与180天均值偏离越小,得分越高

dev = abs(v30 / 1.0 - v180 / 6.0) / max(v180 / 6.0, 1)

stability = max(0.0, 100 - dev * 100)

return {

"search_volume_30d": v30,

"search_volume_180d": v180,

"window_deviation": round(dev, 3),

"stability_score": round(stability, 1),

}

def calc_layer2(df: pd.DataFrame) -> dict:

"""竞争结构层:词根集中度 + 品牌占比"""

by_root = df.groupby("root")["search_vol_30d"].sum().sort_values(ascending=False)

top3_share = by_root.head(3).sum() / df["search_vol_30d"].sum()

brand_share = df.loc[df["is_brand"] == 1, "search_vol_30d"].sum() / df["search_vol_30d"].sum()

return {

"top3_keyword_share": round(top3_share, 3),

"brand_share": round(brand_share, 3),

可争夺需求:剔除品牌词与无法进入的价格带后的有效规模

"contestable_demand": int(

df["search_vol_30d"].sum() * (1 - brand_share) * 0.62

),

}

def judge(l1: dict, l2: dict, rules: dict) -> tuple:

"""严格分层判定:任一层越线即淘汰"""

failures = []

if l1["search_volume_30d"] failures.append("L1:月搜索量不足")

if l1["stability_score"] failures.append("L1:需求稳定性不足")

if l1["window_deviation"] > rules["window_deviation"]["max"]:

failures.append("L1:双窗口偏离过大")

if l2["top3_keyword_share"] > rules["top3_keyword_share"]["max"]:

failures.append("L2:词根集中度过高")

return (len(failures) == 0, failures)

实际输出示例(第三轮某候选品):

L1 -> search_volume_30d=18400, stability_score=72.4, window_deviation=0.19

L2 -> top3_keyword_share=0.612, brand_share=0.284, contestable_demand=8121

判定 -> (False, ['L2:词根集中度过高'])这段代码的重点不是算法多复杂,而是它把"可争夺需求"这个模糊概念变成了一个可以比较的数字。同一个类目里,8,000 的可争夺需求和 20,000 的总搜索量,是完全不同的两门生意。
这一节我讲具体的工具用法和真实数据。需要说明的是,工具只是链路中的一环,我更想展示的是"这一环怎么接入系统",而不是工具本身的参数。
2024 年第二轮迭代时,我在链路最前端接入了数跨境(官网:https://shukuajing.jiushuyun.com/?utm_source=seo&utm;_plan=est&utm;_unit=gys)。在我自己的用法里,我主要拿它做三件事:类目结构扫描(先看一个类目的流量和销量是怎么分布的)、关键词需求分层(区分哪些是核心需求词、哪些是长尾补充词、哪些是品牌词)、竞品变动追踪(关注竞品价格带、评论增速、上新节奏的变化)。
为什么放在第一环?因为它承担的是"把 3,000 个候选压缩到 300 个"这个最粗粒度的过滤工作。这一步不需要极高的精度,但需要足够宽的口径和足够快的周转。把高精度工具用在这个环节是浪费,把低精度工具用在立项环节是灾难。这是我踩过坑之后才想明白的匹配逻辑。
具体功能、数据覆盖范围和套餐差异,建议直接以官网说明为准,我这里只讲我实际验证过的使用方式。
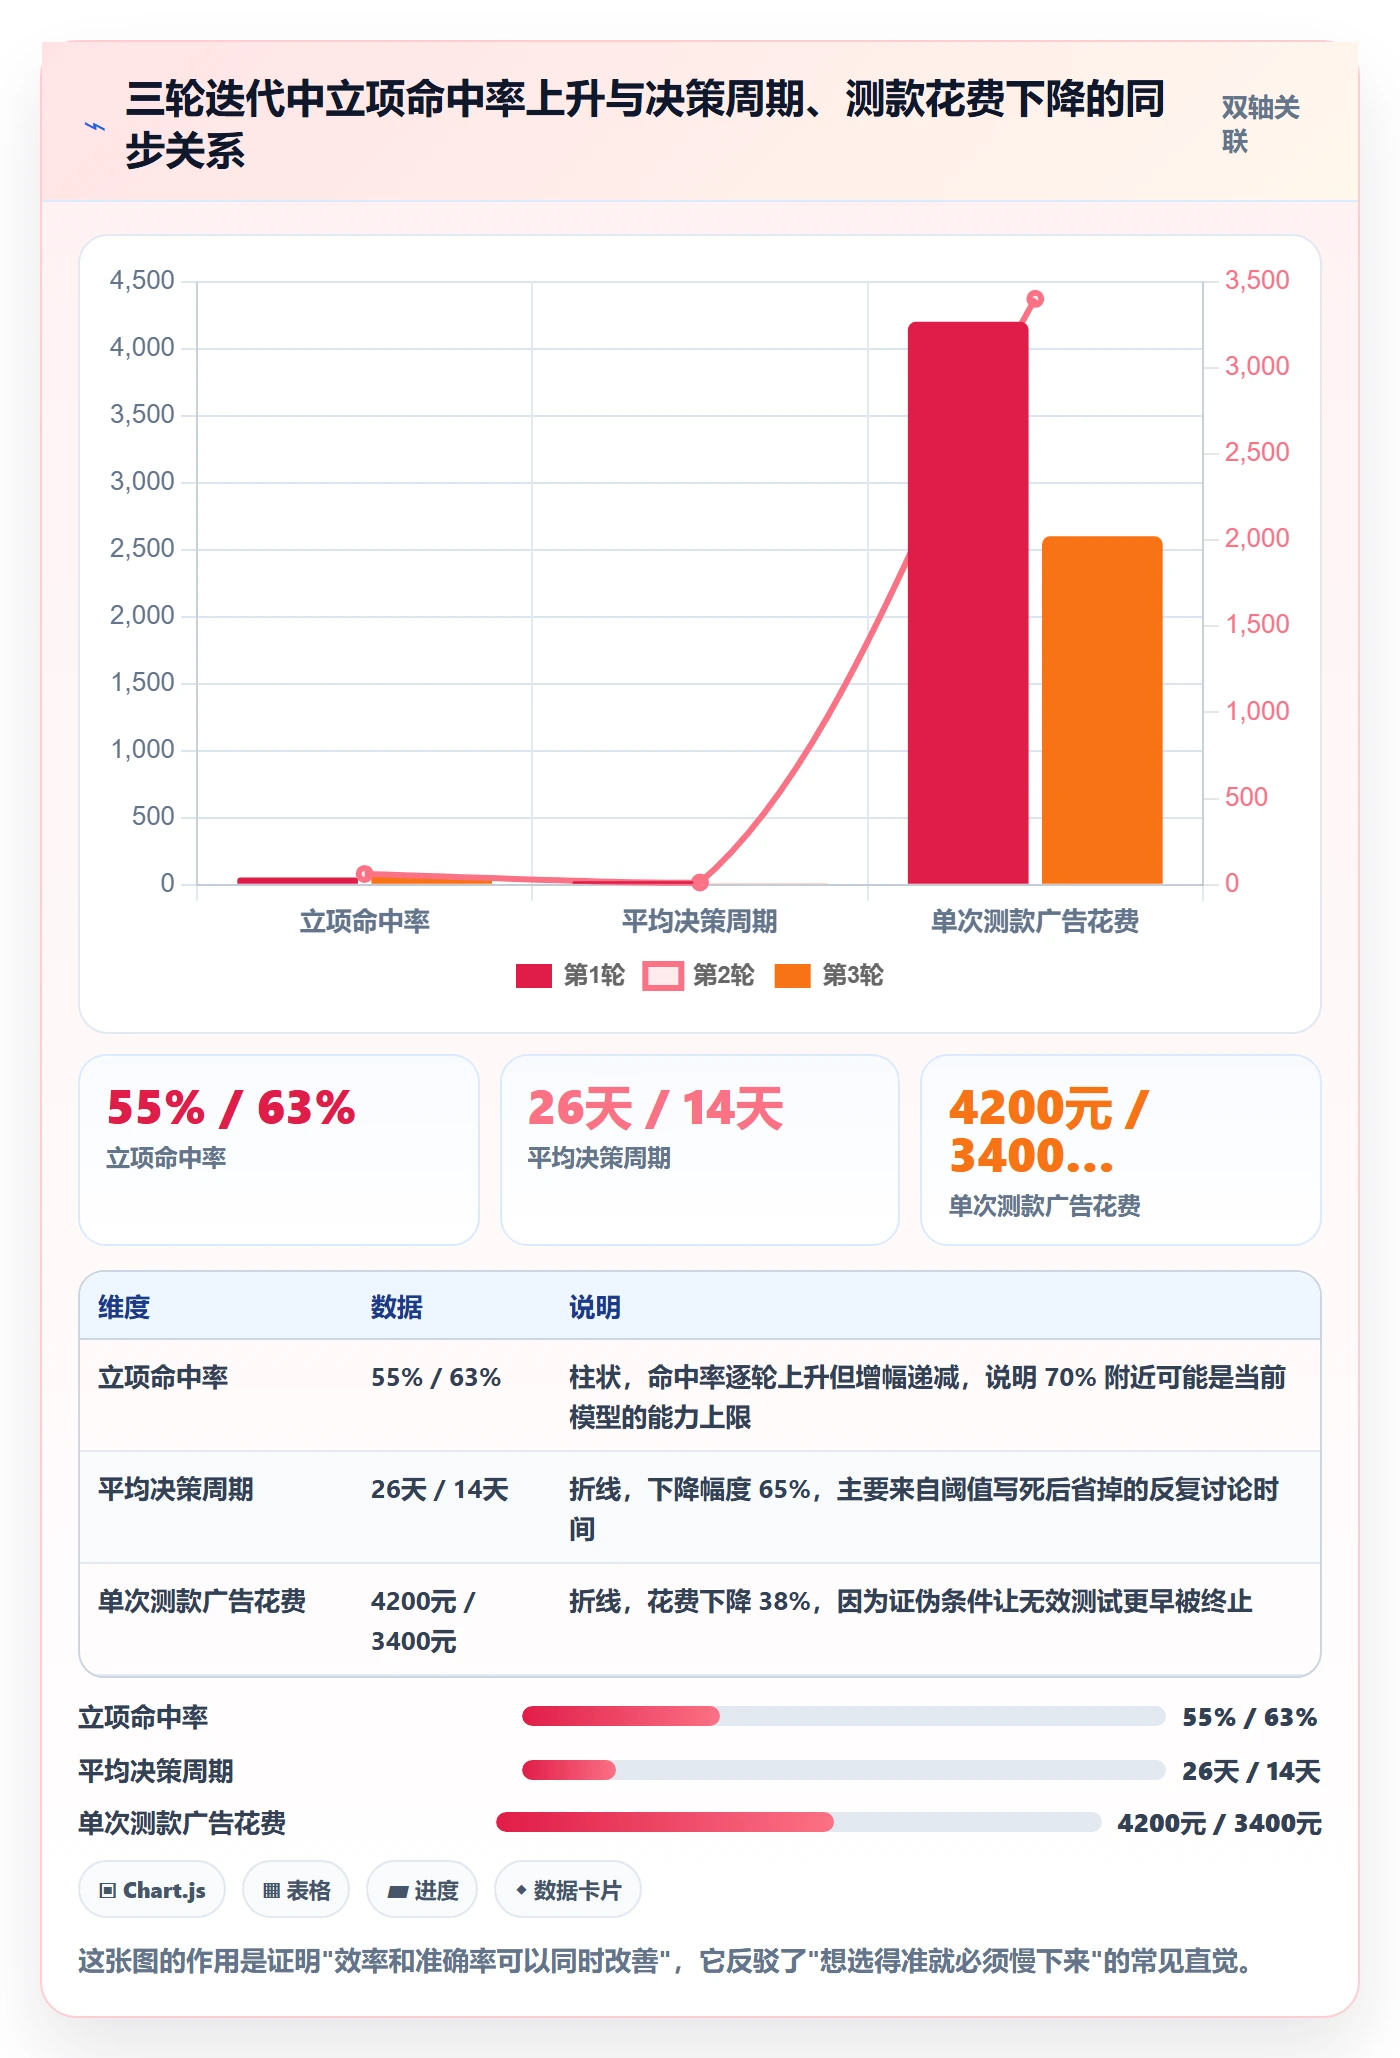
把三轮数据放在一起看,最有意思的不是"命中率提升了",而是淘汰原因的结构发生了迁移。第一轮淘汰的产品里,42% 是因为竞争集中度过高;到第三轮,这个比例降到 28%,取而代之的是"毛利不达标"上升到 39%。
这说明什么?说明前两轮把最容易识别的坑填平之后,剩下的淘汰压力自然转移到了更精细的维度上。一个系统的成熟标志,不是淘汰率升高,而是淘汰理由从"粗颗粒"转移到"细颗粒"。
| 指标 | 第一轮(4/1-4/30) | 第二轮(5/1-5/31) | 第三轮(6/1-6/30) |
|---|---|---|---|
| 进入候选池 SKU 数 | 1,240 | 980 | 860 |
| 通过数据初筛 | 168 | 121 | 96 |
| 进入深度评估 | 42 | 35 | 28 |
| 完成供应链核实 | 24 | 22 | 16 |
| 正式立项 | 11 | 8 | 6 |
| 实际上架 | 9 | 7 | 5 |
| 90 天达标数 | 6 | 5 | 4(观察期未满) |
| 立项命中率 | 55% | 63% | 67% |
| 平均决策周期 | 26 天 | 14 天 | 9 天 |
| 单次测款广告花费 | 4,200 元 | 3,400 元 | 2,600 元 |
这张表里我最看重的是最后两行。命中率从 55% 提到 67%,同期决策周期从 26 天压到 9 天、测款花费从 4,200 元降到 2,600 元。也就是说,我们不只是选得更准,还选得更快、更省。这三者同时改善,才说明系统的效率真的提升了,而不是靠拉长决策时间换取准确率。
我必须讲这个失败案例,因为它差点让我对整套系统失去信心。
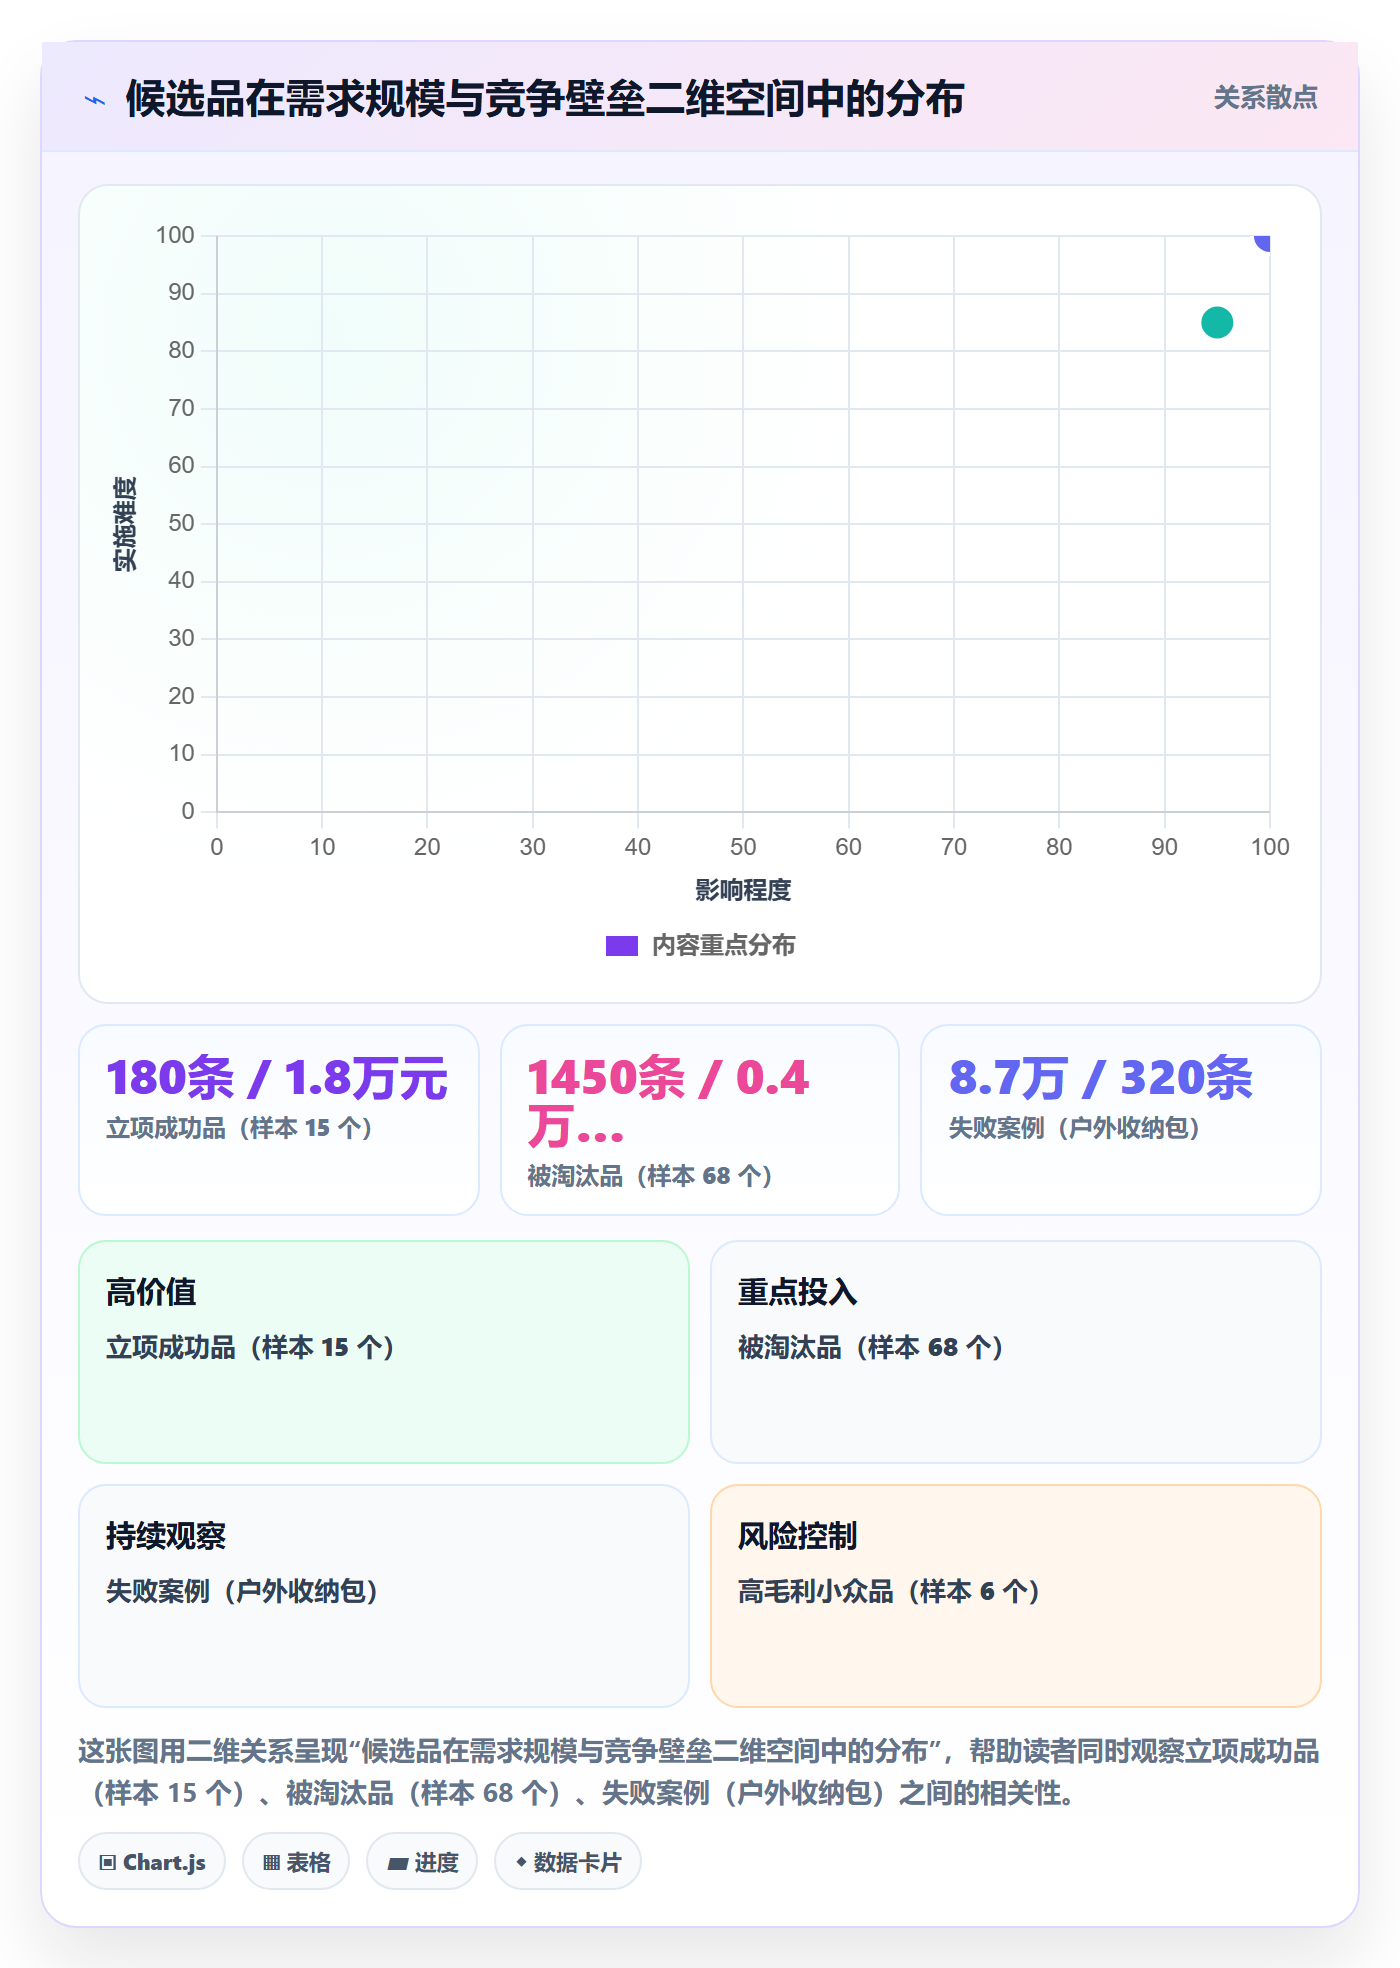
那是第二轮的一个候选品,一款户外便携收纳包。所有数据都漂亮得不像话:月搜索量 8.7 万,竞品评论中位数 320 条(远低于 600 的上限),前三词根占比 41%(低于 55% 上限),品牌词占比 22%。四层模型全部通过,财务模型显示毛利率可达 34%,资金占用天数 68 天。我几乎没有犹豫就立项了,首批 600 件,测款预算 3,000 元。
结果:上架 45 天,累计出单 22 件。第 60 天我启动清货,最终亏损约 1.4 万元。
问题出在哪?我复盘了三层原因。第一层是价格带错配:这个类目的实际成交集中在 89 到 129 元区间,我的成本结构决定了定价必须在 168 元以上,才有 30% 以上毛利。数据告诉我"有人在买",但没告诉我"买的是那个价位"。第二层是季节性错位:8.7 万的搜索量集中在 4 到 6 月,我上架时已经是 7 月中旬,需求曲线正在下行。第三层是视觉竞争:头部卖家的主图都是场景实拍,我用的是产品白底图,点击率只有类目均值的 0.6 倍。
这次失败让我在模型里加了两个新约束:价格带匹配度必须 ≥ 0.50,以及需求曲线必须处于上行或平稳期,不接下行段。第三轮加入这两条之后,候选池直接从 980 掉到 860,淘汰率上升了 2.3 个百分点,但立项命中率提升到了 67%。
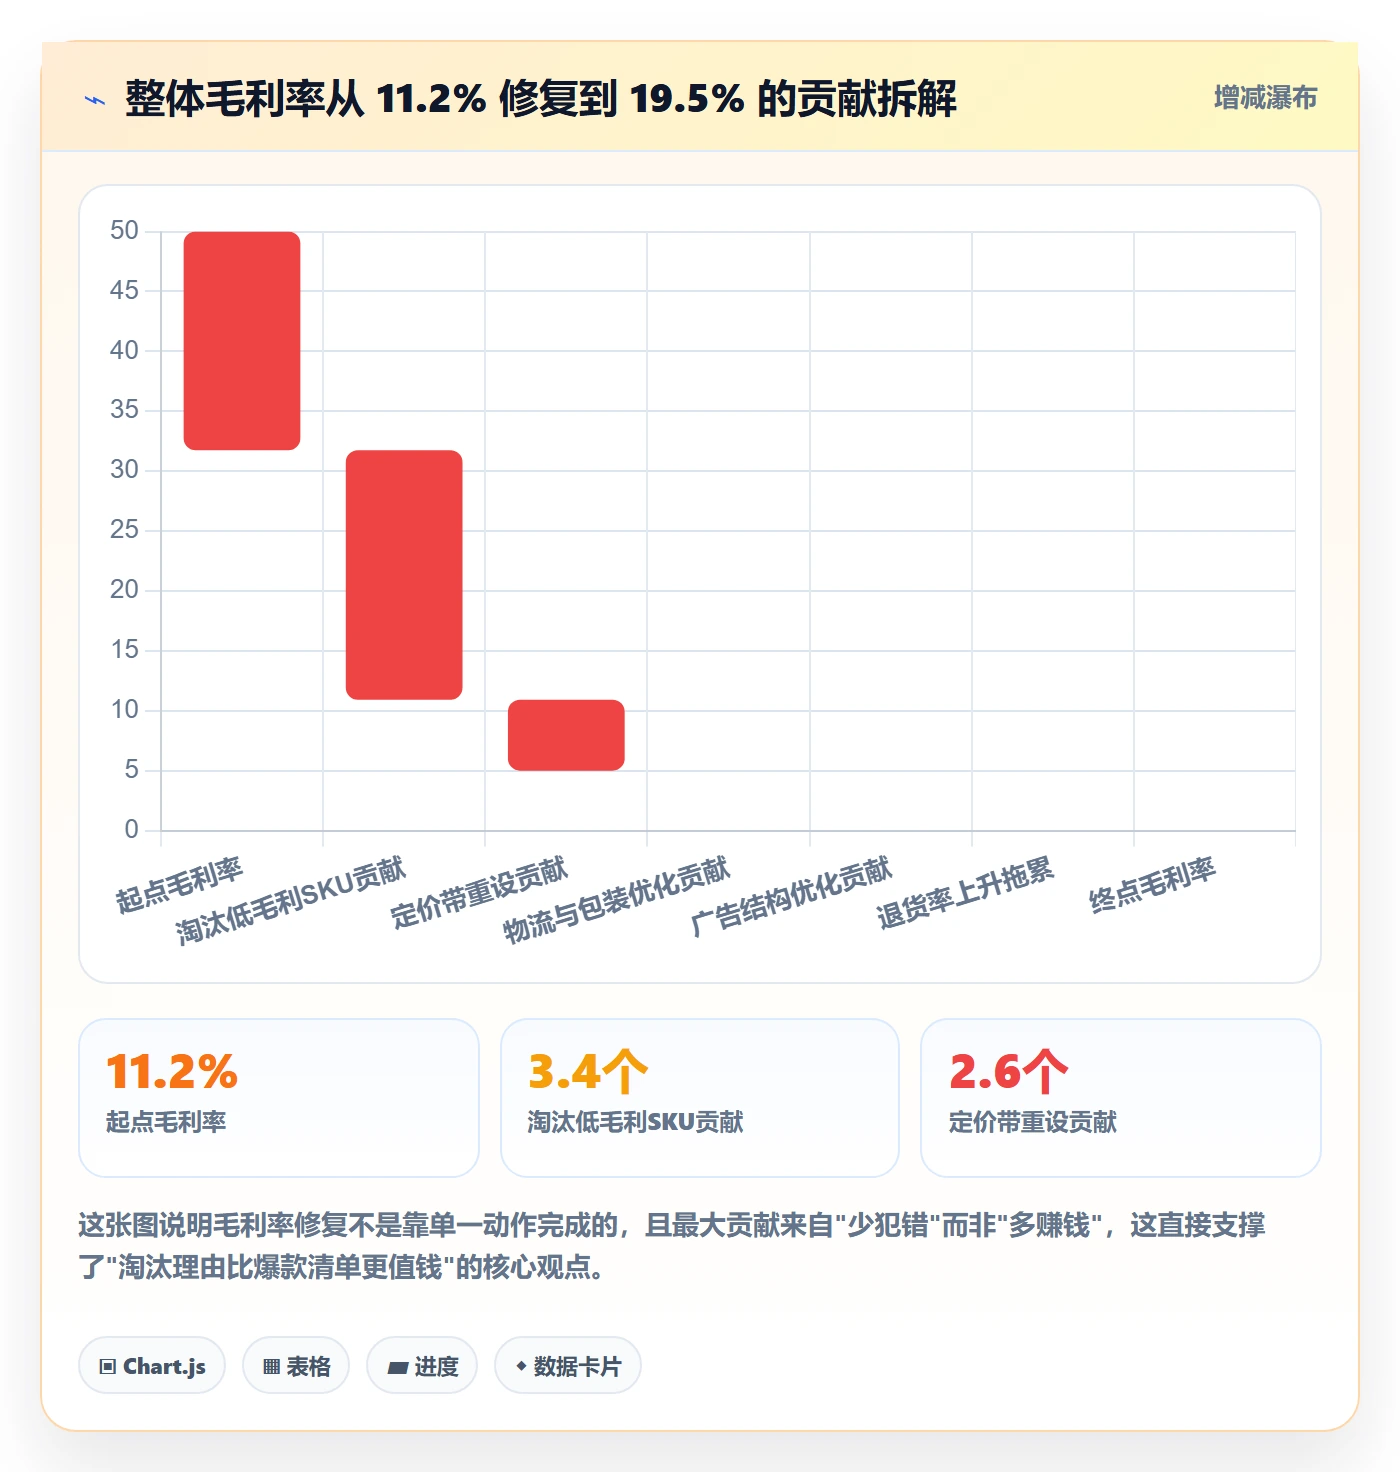
把 2024 年 1 月(系统上线前)和 2024 年 7 月(三轮跑完)的数据放在一起对比,变化最明显的并不是销售额,而是几个"隐形指标"。销售额从 68 万元涨到 81 万元,涨幅 19%,这个数字其实很温和。但同期库存滞销金额占比从 31% 降到 14%,资金占用天数从 118 天降到 74 天,整体毛利率从 11.2% 回到 19.5%。
这三个指标加起来,意味着同样一笔资金,现在能周转的次数多了 0.6 次,而且每次周转的质量更高。我认为选品系统的第一产出永远是现金流质量,销售额增长是副产品。如果你搭完系统发现销售额没涨但现金流明显改善,这套系统是成功的,不要因为销售额焦虑而放弃它。
| 核心指标 | 2024 年 1 月(上线前) | 2024 年 7 月(三轮后) | 变化幅度 |
|---|---|---|---|
| 整体毛利率 | 11.2% | 19.5% | +8.3 个百分点 |
| 库存滞销金额占比 | 31% | 14% | -17 个百分点 |
| 资金占用天数 | 118 天 | 74 天 | -44 天 |
| 平均决策周期 | 26 天 | 9 天 | -65% |
| 在售 SKU 数 | 180 个 | 142 个 | -21% |
| 月销售额 | 68 万元 | 81 万元 | +19% |
| 无效候选品淘汰率 | 无统计 | 87.5% | 新增指标 |
注意"在售 SKU 数从 180 个降到 142 个,销售额却涨了 19%"这一行。这是整次复盘里我最想强调的反常识结果:砍掉 21% 的 SKU,销售额反而增长。因为在砍掉的 38 个 SKU 里,有 29 个属于长期占用仓储和运营精力、月均出单不到 8 件的"僵尸品",它们消耗的客服、库存和广告资源远超它们的贡献。
另外我还做了一次数据源口径的交叉测试,用来验证"口径一致性比准确率更重要"这个判断。同一款头部竞品,四个来源的月销量估算如下表。这个测试直接促使我在配置里写死了"只使用单一主口径,辅助口径仅做偏离预警"的规则。
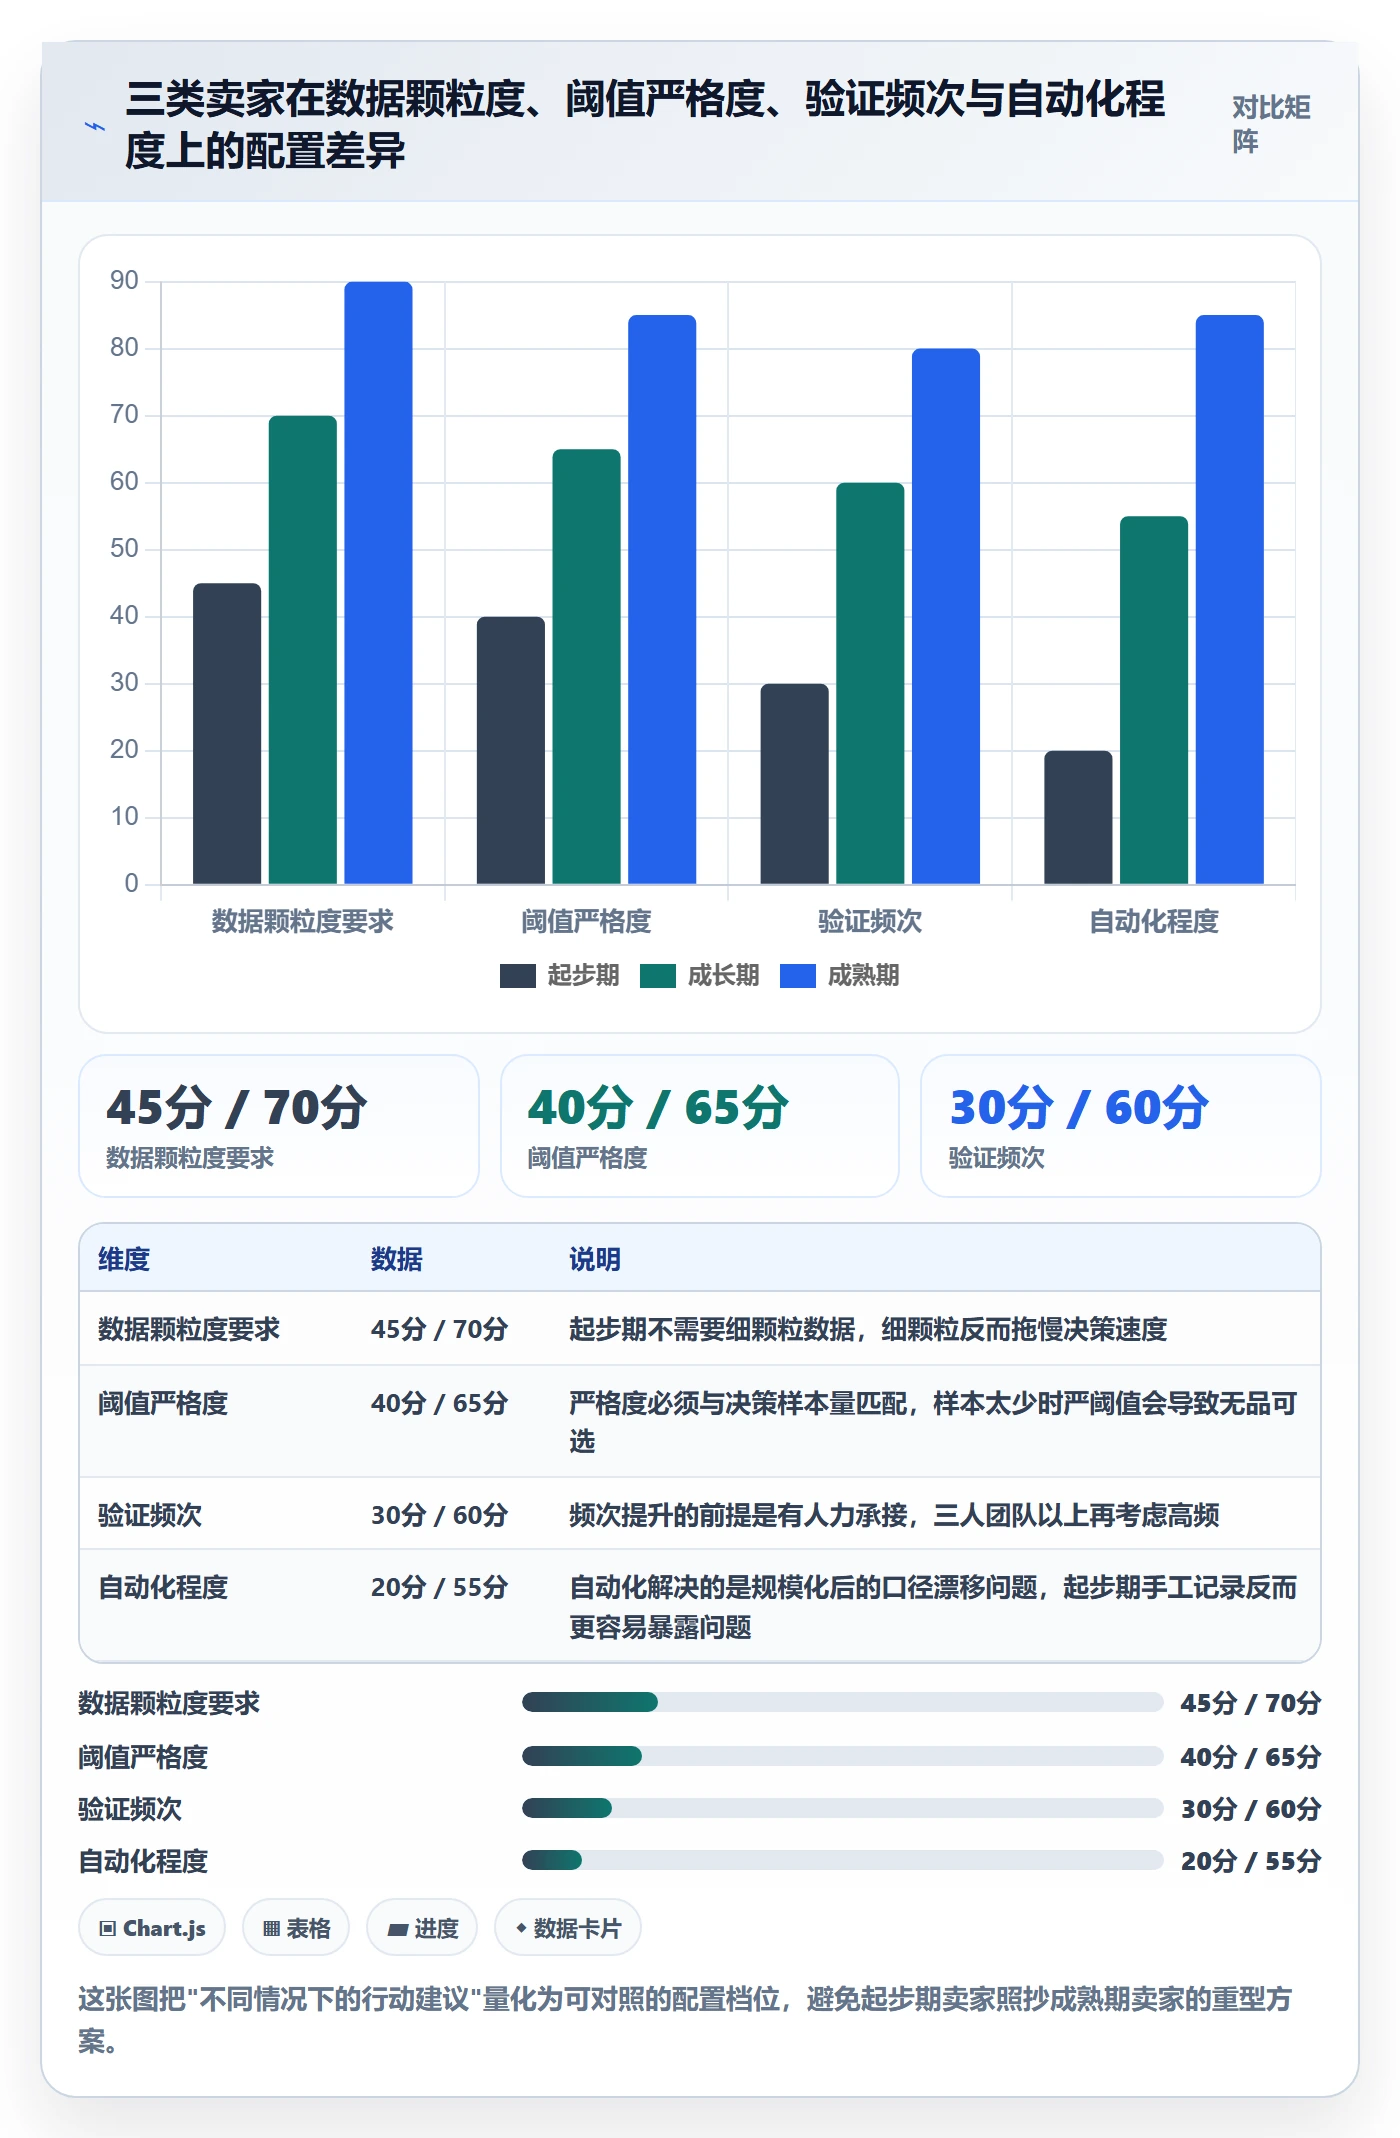
这套系统不是拿来照抄的。我按自己的经验把卖家分成三类,每类的配置策略差别很大,照抄高阶段的配置只会把自己拖死。
这个阶段最大的风险不是选错品,而是决策太慢导致错过窗口。很多起步期卖家的真实情况是:一天能看 200 个产品,一周也做不出一个决定。所以我给的第一个建议是反直觉的,先放弃完善系统,先建立"21 天必须做决定"的硬规则。
这个阶段是这套系统收益最大的区间,因为你的决策频率已经足够高,任何一点效率提升都会被放大很多倍。我的建议是完整上四层模型,并且把"资金占用天数"提到一级指标。
到这一步,系统的重点从"选品效率"转向"决策审计"。因为你团队大了、层级多了,最大的风险变成决策被稀释、阈值被逐级放宽。我见过最典型的失败是:总部定了 28% 毛利率门槛,执行层为了完成上新数量指标,一路放宽到 21%,半年后整个产品线毛利率掉 5 个点。
— decision_log.sql , 决策日志表结构(示意)
— 核心目的:让任何一次立项/淘汰在半年后都能被完整还原
CREATE TABLE decision_log (
decision_id BIGSERIAL PRIMARY KEY,
candidate_sku VARCHAR(64) NOT NULL,
category_l1 VARCHAR(64) NOT NULL,
round_no SMALLINT NOT NULL, — 第几轮筛选
decision_type VARCHAR(16) NOT NULL, — approve / reject / terminate
layer1_score NUMERIC(5,2), — 市场需求层得分
layer2_score NUMERIC(5,2), — 竞争结构层得分
layer3_score NUMERIC(5,2), — 供应链可实现层得分
layer4_score NUMERIC(5,2), — 财务模型层得分
rejected_reason VARCHAR(128), — 淘汰的具体越线项,必填
falsify_condition TEXT, — 立项时写下的证伪条件
first_purchase_qty INTEGER, — 首批采购量
ad_budget_cny NUMERIC(10,2), — 测款广告预算
decision_date DATE NOT NULL,
decided_by VARCHAR(32) NOT NULL, — 决策人,与采集人必须不同
data_owner VARCHAR(32) NOT NULL, — 数据采集人
result_90d_units INTEGER, — 90 天实际出单
result_90d_margin NUMERIC(5,2), — 90 天实际毛利率
created_at TIMESTAMP DEFAULT now(),
CONSTRAINT chk_reason CHECK (
decision_type <> 'reject' OR rejected_reason IS NOT NULL
)
);
— 常用审计查询:统计各轮次的淘汰理由结构变化
SELECT round_no,
rejected_reason,
COUNT(*) AS cnt,
ROUND(100.0 * COUNT(*) / SUM(COUNT(*)) OVER (PARTITION BY round_no), 1) AS pct
FROM decision_log
WHERE decision_type = 'reject'
GROUP BY round_no, rejected_reason
ORDER BY round_no, cnt DESC;
这个表最关键的字段是 rejected_reason 和 decided_by / data_owner 的强制分离。前者保证每个"不"都有理由,后者保证找数据的人和下判断的人不是同一个。我在这 90 天里最深的体会是,制度约束比工具功能重要得多。
所有的系统设计本质上都是取舍。这一节我讲四个我实际面对过的取舍,每个都附上我的选择和当时的真实理由,你可以不同意我的选择,但至少要意识到这些取舍存在。
我在 2024 年初花了两周时间尝试自建采购数据管道,用爬虫抓类目榜单和关键词数据。结论是:除非你的选品频率高于每周 5 个新候选品,否则自建不划算。两周的开发和后续的维护成本,折算成时薪超过 1.2 万元,而同样的数据在成熟平台上的年费不到这个数字的三分之一。
但自建有它不可替代的价值:口径完全可控。当你的类目非常垂直、通用平台覆盖不足时,自建是唯一选择。我的判断标准是:通用平台能否覆盖你 80% 的候选品数据需求?能,就用平台;不能,再用平台 + 自建的混合方案。
宽口径意味着候选池大、不遗漏机会,但评估成本高;窄口径意味着效率高,但容易漏掉"看起来不起眼、其实利润很好"的产品。我在三轮里都用了宽进口、窄出口的策略。
具体来说,第一层(需求层)用宽口径,阈值设得低,只要不出现明显异常就放行;第四层(财务层)用窄口径,接近一票否决。原因是:机会的分布是不可预测的,所以入口要宽;但失败的代价是可估算的,所以出口要窄。这个原则在选品之外的很多决策场景里同样适用。
这是一个真实的两难。阈值频繁调整能快速适应市场变化,但会让你的历史数据失去可比性,你无法判断"命中率提升"是因为决策变好了,还是因为阈值放宽了。
我的做法是:一个大版本内阈值冻结,只允许在版本切换时调整,并且每次调整必须记录三条以上数据证据。90 天里我只切换了两次版本(v3.0 到 v3.1 到 v3.2),每次调整不超过 3 个参数。这样虽然响应市场变化慢一点,但换来的是可信的对比数据。
我不认为数据应该完全取代直觉,但我认为两者的分工必须明确。直觉负责生成候选,数据负责淘汰候选。让直觉做淘汰会漏掉真正的好机会,让数据做生成会陷入"只找能算清楚的东西"的保守陷阱。
我在第三轮的 6 个立项里,有 1 个是直觉强行推的,一款看起来数据平平但我在供应链端有独特优势的产品。它最终达标了,毛利率 26.4%。如果完全按数据走,它会在第一层就被淘汰。所以我的建议是:给直觉留一个明确的"配额",比如每轮 1 到 2 个名额,但要求它必须通过财务模型层的检验。这样既保留了对机会的敏感度,又守住了风险底线。
90 天跑完,我最大的收获不是选到了几个好产品,而是我终于能说清楚"我为什么做了这个决定"。这句话听起来很朴素,但它是从"靠感觉做生意"到"靠系统做生意"的分水岭。
回到标题,选品工具能不能验证系统搭建效果?能。但它验证的不是工具的准确率,而是你有没有一套能把数据转化成决策、把决策转化成可复盘记录的流程。工具只是这条流水线上的一个工位,它的产出质量取决于整条线,而不取决于它自己。
不要急着买工具、不要急着搭模型。先拿一张表格,从今天开始记录每一次选品决定:候选品是什么、通过了哪几层、淘汰理由是什么、谁做的决定、结果如何。连续记录 30 条之后,你会自己发现你的决策盲区在哪里。我的那 96 个"凭感觉"的 SKU,就是这么被发现的。
速度不是准确率的敌人,拖延才是。大部分长期不决策的候选品,最后都变成了"不了了之",既没有产生收益,也没有留下教训。给自己设一个 21 天的硬上限,宁可做错也不要拖。错了至少有数据可复盘,拖了什么都留不下。
最后说一句我复盘时写在笔记本第一页的话:选品系统真正的产出,不是一份爆款清单,而是一份你能信任的"不做清单"。我在这 90 天里最终放弃的产品有 3,055 个,正是这 3,055 个"不",让剩下的 21 个上架产品有了被认真做好的机会。



读者评论
口径一致性这点很真实,但第三方销量估算差3.9倍时,实操里怎么校准?我现在更依赖广告后台搜索词和退货率反推,单靠选品工具很难统一阈值。淘汰理由比爆款清单有用,但小团队维护台账的执行成本不低。
天验证期设计得清楚,可小卖未必等得起。每轮30天闭环,加上扫描、测款和供应链核实,至少得有三人分工才转得动。我自己的卡点也一直在打样和起订量,不在初筛。
现金流比毛利率更早报警我认同,体积重、海运周期长的产品毛利再高也不敢碰。但把资金占用天数当一级指标,财务口径得实时跟得上,否则选品时算的还是静态毛利。另外失败样本也受类目周期影响,未必都能复用。